Gemini Omni
Le modèle de création multimodal de Google — là où le raisonnement de Gemini rencontre la capacité de créer. Générez et éditez des vidéos à partir de texte, d'images, de vidéo ou d'audio en langage naturel. Chaque modification s'appuie sur la précédente. Essayez gratuitement avec GPT Image 2.5 AI video generator.
Gemini Omni
À propos de Gemini Omni
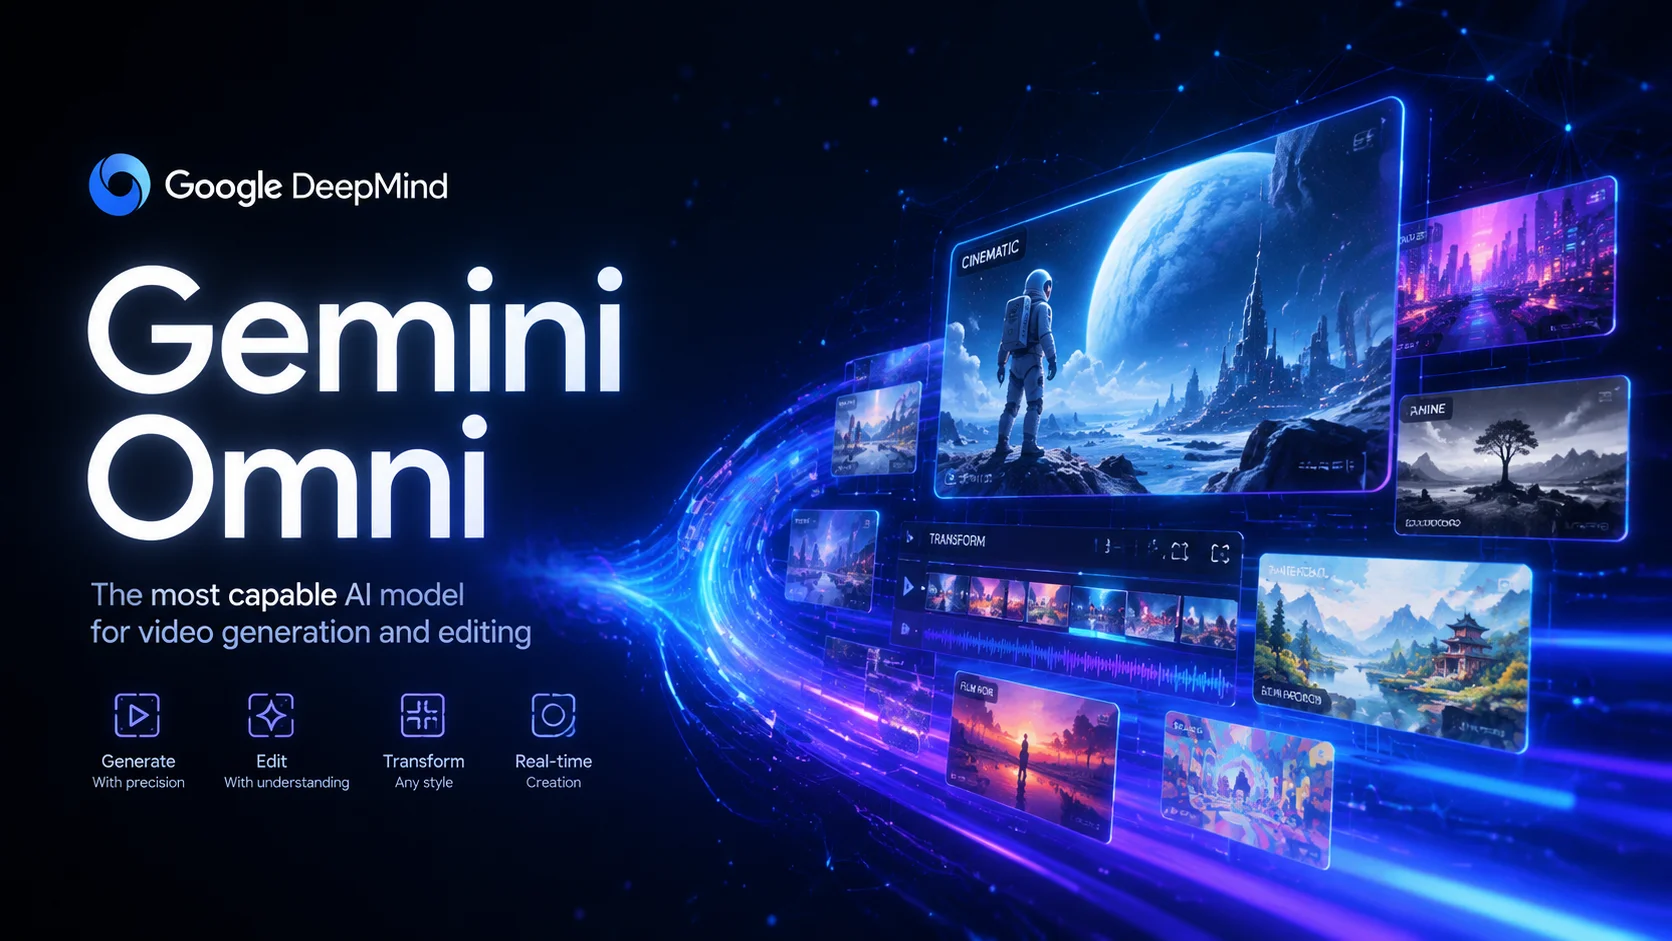
Gemini Omni est le modèle de création multimodal de Google DeepMind, annoncé lors de Google I/O 2025. Il associe la capacité de raisonnement de Gemini aux systèmes de génération de médias, permettant une création et une édition vidéo qui vont au-delà de la simple conversion prompt-vers-vidéo. Le modèle comprend les scènes, les actions, les environnements, les comportements physiques et le contexte du monde réel — produisant des résultats qui semblent intentionnels plutôt qu'aléatoires. Gemini Omni Flash est le premier modèle de la famille Omni, conçu pour des flux de travail pratiques de création et d'édition vidéo où les utilisateurs peuvent transformer des séquences, guider les résultats avec des références et affiner les scènes par la conversation en langage naturel.
Capacités clés
Entrée multimodale, édition conversationnelle, transformation de style et connaissances du monde réel — le tout dans un seul modèle
Core Features Overview
Édition conversationnelle multi-tours
Gemini Omni introduit une approche fondamentalement différente de l'édition vidéo. Au lieu de repartir de zéro à chaque génération, vous pouvez affiner votre vidéo par une série d'instructions en langage naturel. Changez l'arrière-plan, ajustez l'action, remplacez des objets, modifiez l'angle de caméra ou ajoutez des effets visuels — tout en gardant le reste de la vidéo stable. Ce flux de travail conversationnel signifie que vous pouvez itérer vers votre vision étape par étape, comme si vous éditiez un document avec suivi des modifications.
Éditer en plusieurs tours : d'abord établir la scène, puis changer l'angle de caméra, puis ajouter des effets atmosphériques — en maintenant la cohérence tout au long
L'édition multi-tours préserve la cohérence de la scène à travers les modifications séquentielles
D'abord établir la scène avec une personne dans une pièce, puis changer l'éclairage en heure dorée, puis ajouter de la pluie sur la fenêtre — chaque modification s'appuie sur la précédente
Les changements séquentiels d'environnement démontrent le raffinement conversationnel
Transformation de style en temps réel
Gemini Omni peut transformer le style visuel de n'importe quelle vidéo source tout en préservant le mouvement sous-jacent, la structure et la composition de la scène. Décrivez l'esthétique cible — surfaces métalliques, croquis dessinés à la main, marionnettes en feutre, projections holographiques, art voxel — et le modèle applique la transformation de manière cohérente sur chaque image. Le mouvement de caméra original, les actions des personnages et les relations spatiales restent intacts, créant un transfert de style fluide qui va bien au-delà des simples filtres.
Quand la personne touche le miroir, faire onduler le miroir comme un liquide, et le bras de la personne se transforme en matériau miroir réfléchissant
La transformation de style préserve le mouvement tout en changeant complètement l'esthétique visuelle
Quand la personne touche le miroir, tout l'environnement se transforme en art voxel 3D avec des formes géométriques en blocs
Transformation complète de l'environnement en art voxel tout en préservant la structure spatiale
Entrée véritablement multimodale
Contrairement aux modèles qui n'acceptent que du texte ou une seule image, Gemini Omni peut traiter plusieurs types d'entrées simultanément. Fournissez du texte pour la direction, des images pour la référence visuelle, de la vidéo pour le guidage du mouvement et de l'audio pour la synchronisation vocale ou sonore. Le modèle synthétise toutes les entrées en une seule sortie vidéo cohérente. Cela le rend pratique pour les flux de travail créatifs réels où l'inspiration vient de sources multiples — un croquis de storyboard, un clip de référence, un enregistrement vocal et une description écrite peuvent tous contribuer au résultat final.
Ajouter des sons de harpe synchronisés au moment où je touche chaque feuille de fougère. Transformer la structure des feuilles en plantes bioluminescentes avec des lucioles volant autour
Combinaison d'une entrée vidéo avec des instructions textuelles et une référence audio pour une sortie synchronisée
Visualiser le processus de repliement des protéines en utilisant des connaissances scientifiques réelles, rendu en style claymation avec un comportement moléculaire précis
Connaissances du monde réel appliquées à la visualisation scientifique avec un style créatif
Questions fréquentes
Gemini Omni FAQ
Ce que les créateurs disent de Gemini Omni
"L'édition multi-tours est ce qui distingue Gemini Omni. Je peux affiner une scène étape par étape au lieu de tout régénérer à chaque fois. On a vraiment l'impression de diriger plutôt que de simplement écrire des prompts."
Elena Vasquez
Directrice créative
"L'édition multi-tours est ce qui distingue Gemini Omni. Je peux affiner une scène étape par étape au lieu de tout régénérer à chaque fois. On a vraiment l'impression de diriger plutôt que de simplement écrire des prompts."
Elena Vasquez
Directrice créative
Explorer Plus de Modèles Vidéo IA


Commencez à créer avec Gemini Omni
 +1k