Gemini Omni
Googles multimodales Erstellungsmodell — wo Geminis Denkfähigkeit auf kreative Gestaltung trifft. Erstelle und bearbeite Videos aus Text, Bildern, Video oder Audio mit natürlicher Sprache. Jede Bearbeitung baut auf der vorherigen auf. Kostenlos testen mit GPT Image 2.5 AI video generator.
Gemini Omni
Über Gemini Omni
Gemini Omni ist das multimodale Erstellungsmodell von Google DeepMind, vorgestellt auf der Google I/O 2025. Es vereint Geminis Denkfähigkeit mit generativen Mediensystemen und ermöglicht Videogenerierung und -bearbeitung, die über einfache Prompt-zu-Video-Ausgabe hinausgeht. Das Modell versteht Szenen, Handlungen, Umgebungen, physikalisches Verhalten und realen Kontext — und liefert Ergebnisse, die gezielt wirken statt zufällig. Gemini Omni Flash ist das erste Modell der Omni-Familie, entwickelt für praktische Workflows zur Videoerstellung und -bearbeitung, bei denen Nutzer Filmmaterial transformieren, Ergebnisse mit Referenzen steuern und Szenen durch natürliche Sprachkonversation verfeinern können.
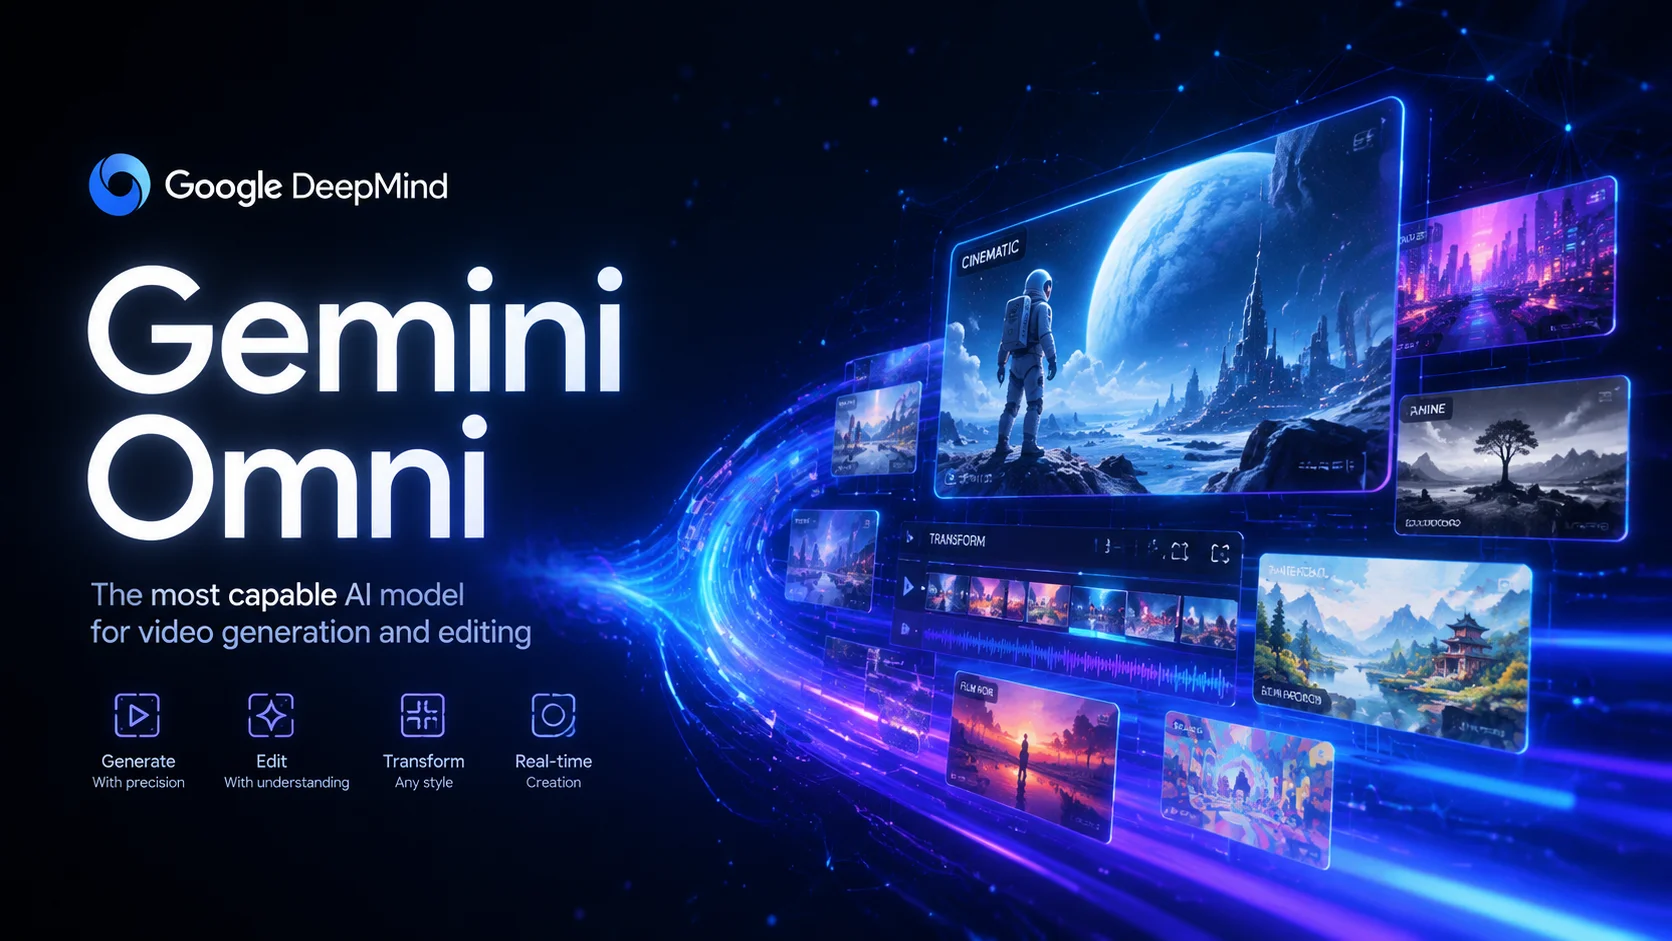
Kernfunktionen
Multimodaler Input, konversationelle Bearbeitung, Stiltransformation und Weltwissen — alles in einem Modell
Core Features Overview
Mehrstufige konversationelle Bearbeitung
Gemini Omni führt einen grundlegend anderen Ansatz zur Videobearbeitung ein. Anstatt bei jeder Generierung von vorne zu beginnen, kannst du dein Video durch eine Reihe natürlichsprachlicher Anweisungen verfeinern. Ändere den Hintergrund, passe die Handlung an, ersetze Objekte, verschiebe den Kamerawinkel oder füge visuelle Effekte hinzu — alles bei gleichzeitiger Stabilität des restlichen Videos. Dieser konversationelle Workflow bedeutet, dass du Schritt für Schritt auf deine Vision hinarbeiten kannst, ähnlich wie beim Bearbeiten eines Dokuments mit nachverfolgten Änderungen.
Bearbeite in mehreren Schritten: Zuerst die Szene aufbauen, dann den Kamerawinkel ändern, dann atmosphärische Effekte hinzufügen — durchgehend Konsistenz bewahren
Mehrstufige Bearbeitung bewahrt die Szenenkohärenz über sequenzielle Änderungen hinweg
Zuerst eine Person in einem Raum etablieren, dann die Beleuchtung auf goldene Stunde ändern, dann Regen am Fenster hinzufügen — jede Bearbeitung baut auf der letzten auf
Sequenzielle Umgebungsänderungen demonstrieren konversationelle Verfeinerung
Echtzeit-Stiltransformation
Gemini Omni kann den visuellen Stil jedes Eingabevideos transformieren und dabei die zugrundeliegende Bewegung, Struktur und Szenenkomposition bewahren. Beschreibe die gewünschte Ästhetik — metallische Oberflächen, handgezeichnete Skizzen, Filzpuppen, holografische Projektionen, Voxel-Kunst — und das Modell wendet die Transformation kohärent auf jeden Frame an. Die ursprüngliche Kamerabewegung, Charakterhandlungen und räumlichen Beziehungen bleiben intakt, was einen nahtlosen Stiltransfer erzeugt, der weit über einfache Filter hinausgeht.
Wenn die Person den Spiegel berührt, soll der Spiegel wunderschön wie Flüssigkeit wellen, und der Arm der Person verwandelt sich in reflektierendes Spiegelmaterial
Stiltransformation bewahrt die Bewegung bei vollständiger Änderung der visuellen Ästhetik
Wenn die Person den Spiegel berührt, verwandelt sich die gesamte Umgebung in 3D-Voxel-Kunst mit blockigen geometrischen Formen
Vollständige Umgebungstransformation in Voxel-Kunst bei Bewahrung der räumlichen Struktur
Echter multimodaler Input
Im Gegensatz zu Modellen, die nur Text oder ein einzelnes Bild akzeptieren, kann Gemini Omni mehrere Eingabetypen gleichzeitig verarbeiten. Gib Text für die Richtung, Bilder als visuelle Referenz, Video für Bewegungsführung und Audio für Sprach- oder Klangsynchronisation an. Das Modell synthetisiert alle Eingaben zu einer einzigen zusammenhängenden Videoausgabe. Das macht es praktisch für reale kreative Workflows, bei denen Inspiration aus mehreren Quellen kommt — eine Storyboard-Skizze, ein Referenzclip, eine Sprachaufnahme und eine schriftliche Beschreibung können alle zum Endergebnis beitragen.
Füge Harfenklänge hinzu, die synchron erklingen, wenn ich jedes Farnblatt berühre. Verwandle die Blattstruktur in biolumineszente Pflanzen mit umherfliegenden Glühwürmchen
Kombination von Videoeingabe mit Textanweisungen und Audioreferenz für synchronisierte Ausgabe
Visualisiere den Proteinfaltungsprozess mit realem wissenschaftlichem Wissen, gerendert im Knetanimationsstil mit genauem molekularem Verhalten
Reales Wissen angewandt auf wissenschaftliche Visualisierung mit kreativem Stil
Häufig gestellte Fragen
Gemini Omni FAQ
Was Creator über Gemini Omni sagen
"Die mehrstufige Bearbeitung hebt Gemini Omni von anderen ab. Ich kann eine Szene Schritt für Schritt verfeinern, anstatt jedes Mal von vorne zu generieren. Es fühlt sich tatsächlich wie Regie führen an, nicht wie Prompting."
Elena Vasquez
Creative Director
"Die mehrstufige Bearbeitung hebt Gemini Omni von anderen ab. Ich kann eine Szene Schritt für Schritt verfeinern, anstatt jedes Mal von vorne zu generieren. Es fühlt sich tatsächlich wie Regie führen an, nicht wie Prompting."
Elena Vasquez
Creative Director
Weitere KI-Video-Modelle entdecken


Starte jetzt mit Gemini Omni
 +1k