Gemini Omni
El modelo de creación multimodal de Google — donde el razonamiento de Gemini se une a la capacidad de crear. Genera y edita video a partir de texto, imágenes, video o audio con lenguaje natural. Cada edición se construye sobre la anterior. Pruébalo gratis con GPT Image 2.5 AI video generator.
Gemini Omni
Acerca de Gemini Omni
Gemini Omni es el modelo de creación multimodal de Google DeepMind, presentado en Google I/O 2025. Combina la capacidad de razonamiento de Gemini con sistemas generativos de medios, permitiendo la generación y edición de video que va más allá de la simple conversión de prompt a video. El modelo comprende escenas, acciones, entornos, comportamiento físico y contexto del mundo real, produciendo resultados que se sienten intencionales en lugar de aleatorios. Gemini Omni Flash es el primer modelo de la familia Omni, diseñado para flujos de trabajo prácticos de creación y edición de video donde los usuarios pueden transformar material, guiar resultados con referencias y refinar escenas mediante conversación en lenguaje natural.
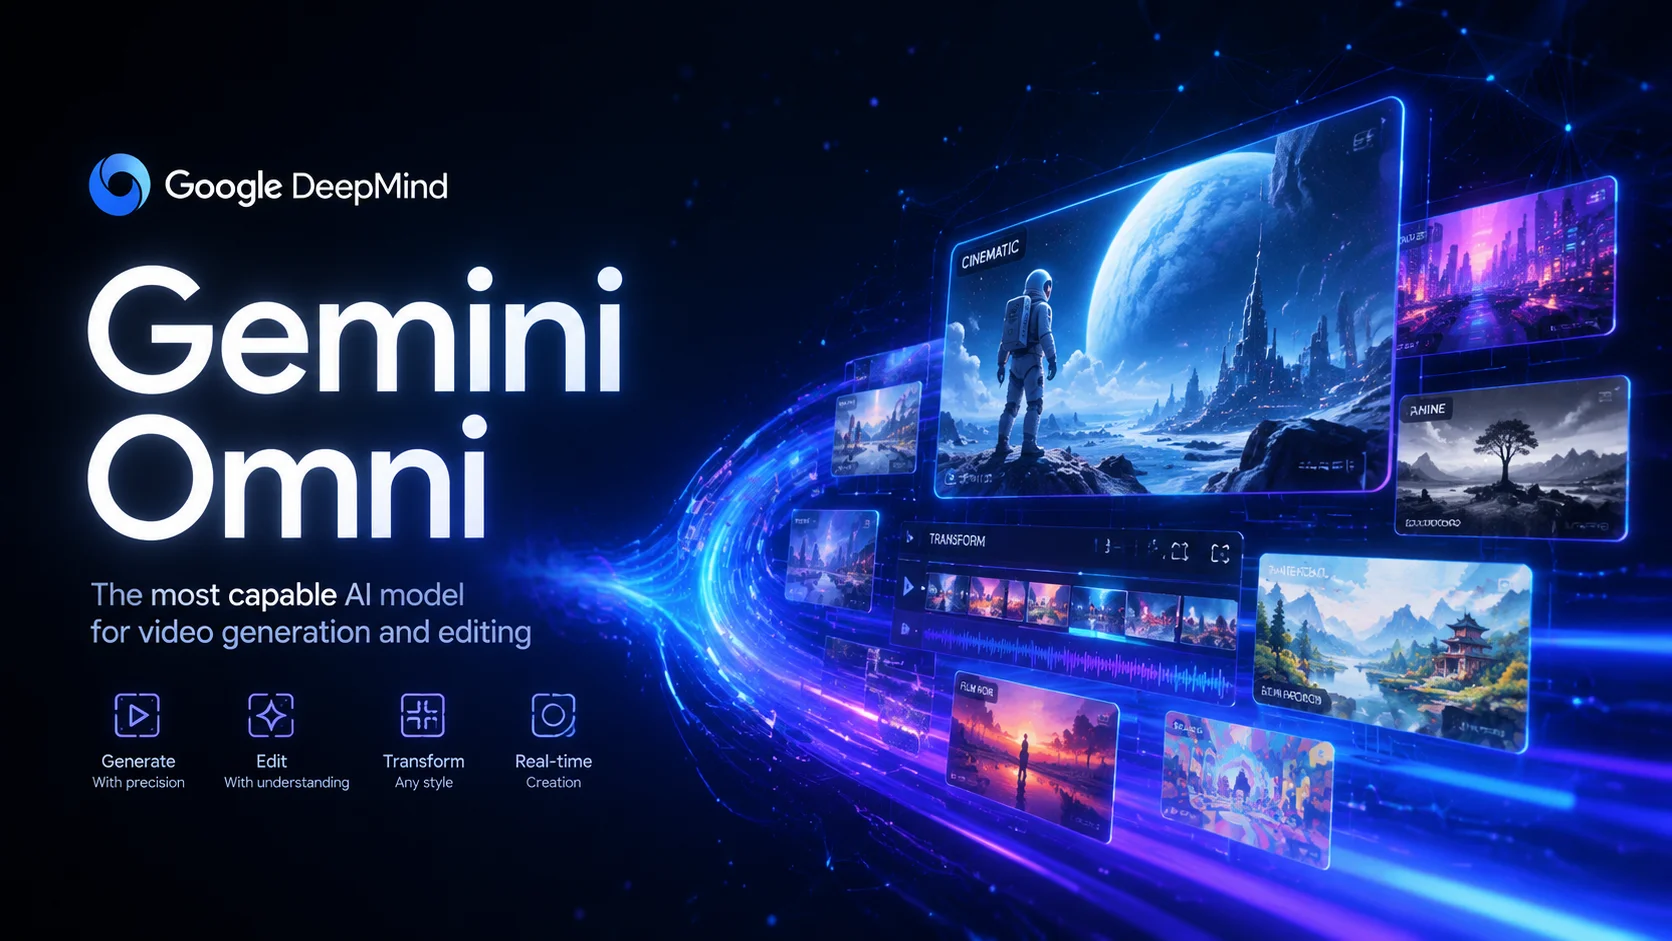
Capacidades Principales
Entrada multimodal, edición conversacional, transformación de estilos y conocimiento del mundo real — todo en un solo modelo
Core Features Overview
Edición Conversacional por Turnos
Gemini Omni introduce un enfoque fundamentalmente diferente para la edición de video. En lugar de empezar desde cero con cada generación, puedes refinar tu video a través de una serie de instrucciones en lenguaje natural. Cambia el fondo, ajusta la acción, reemplaza objetos, modifica el ángulo de cámara o añade efectos visuales — todo mientras mantienes el resto del video estable. Este flujo de trabajo conversacional significa que puedes iterar hacia tu visión paso a paso, igual que editar un documento con control de cambios.
Edita en múltiples turnos: primero establece la escena, luego cambia el ángulo de cámara, después añade efectos atmosféricos — manteniendo la consistencia en todo momento
La edición por turnos preserva la coherencia de la escena a través de modificaciones secuenciales
Primero establecer la escena con una persona en una habitación, luego cambiar la iluminación a hora dorada, luego agregar lluvia en la ventana — cada edición se basa en la anterior
Los cambios secuenciales del entorno demuestran el refinamiento conversacional
Transformación de Estilo en Tiempo Real
Gemini Omni puede transformar el estilo visual de cualquier video de entrada mientras preserva el movimiento subyacente, la estructura y la composición de la escena. Describe la estética objetivo — superficies metálicas, bocetos a mano, marionetas de fieltro, proyecciones holográficas, arte voxel — y el modelo aplica la transformación de forma coherente en cada fotograma. El movimiento de cámara original, las acciones de los personajes y las relaciones espaciales permanecen intactas, creando una transferencia de estilo fluida que va mucho más allá de simples filtros.
Cuando la persona toca el espejo, haz que el espejo ondule hermosamente como líquido, y el brazo de la persona se convierte en material de espejo reflectante
La transformación de estilo preserva el movimiento mientras cambia completamente la estética visual
Cuando la persona toca el espejo, todo el entorno se transforma en arte vóxel 3D con formas geométricas en bloques
Transformación completa del entorno a arte vóxel preservando la estructura espacial
Entrada Verdaderamente Multimodal
A diferencia de modelos que solo aceptan texto o una sola imagen, Gemini Omni puede procesar múltiples tipos de entrada simultáneamente. Proporciona texto para la dirección, imágenes para referencia visual, video para guía de movimiento y audio para sincronización de voz o sonido. El modelo sintetiza todas las entradas en una salida de video única y cohesiva. Esto lo hace práctico para flujos de trabajo creativos reales donde la inspiración proviene de múltiples fuentes — un boceto de storyboard, un clip de referencia, una grabación de voz y una descripción escrita pueden contribuir al resultado final.
Añade sonidos de arpa sincronizados con el momento en que toco cada hoja de helecho. Cambia la estructura de las hojas a vida vegetal bioluminiscente con luciérnagas volando alrededor
Combinando entrada de video con instrucciones de texto y referencia de audio para una salida sincronizada
Visualizar el proceso de plegamiento de proteínas usando conocimiento científico real, renderizado en estilo claymation con comportamiento molecular preciso
Conocimiento del mundo real aplicado a visualización científica con estilo creativo
Preguntas Frecuentes
Gemini Omni FAQ
Lo Que Dicen los Creadores Sobre Gemini Omni
"La edición por turnos es lo que distingue a Gemini Omni. Puedo refinar una escena paso a paso en lugar de regenerar desde cero cada vez. Realmente se siente como dirigir en lugar de solo escribir prompts."
Elena Vasquez
Directora Creativa
"La edición por turnos es lo que distingue a Gemini Omni. Puedo refinar una escena paso a paso en lugar de regenerar desde cero cada vez. Realmente se siente como dirigir en lugar de solo escribir prompts."
Elena Vasquez
Directora Creativa
Explorar Más Modelos de Video IA


Empieza a Crear con Gemini Omni
 +1k