Gemini Omni
Multimodalny model tworzenia od Google — gdzie rozumowanie Gemini spotyka zdolnosc kreacji. Generuj i edytuj wideo z tekstu, obrazow, wideo lub dzwieku za pomoca jezyka naturalnego. Kazda edycja bazuje na poprzedniej. Wyprobuj za darmo z GPT Image 2.5 AI video generator.
Gemini Omni
O Gemini Omni
Gemini Omni to multimodalny model tworzenia od Google DeepMind, zaprezentowany na Google I/O 2025. Laczy zdolnosc rozumowania Gemini z generatywnymi systemami mediow, umozliwiajac generowanie i edycje wideo wykraczajaca poza proste tworzenie filmow z promptow. Model rozumie sceny, akcje, srodowiska, zachowania fizyczne i kontekst swiata rzeczywistego — tworzac wyniki, ktore wygladaja na zamierzone, a nie losowe. Gemini Omni Flash to pierwszy model z rodziny Omni, stworzony do praktycznych procesow tworzenia i edycji wideo, w ktorych uzytkownicy moga transformowac material, kierowac wynikami za pomoca referencji i udoskonalac sceny poprzez konwersacje w jezyku naturalnym.
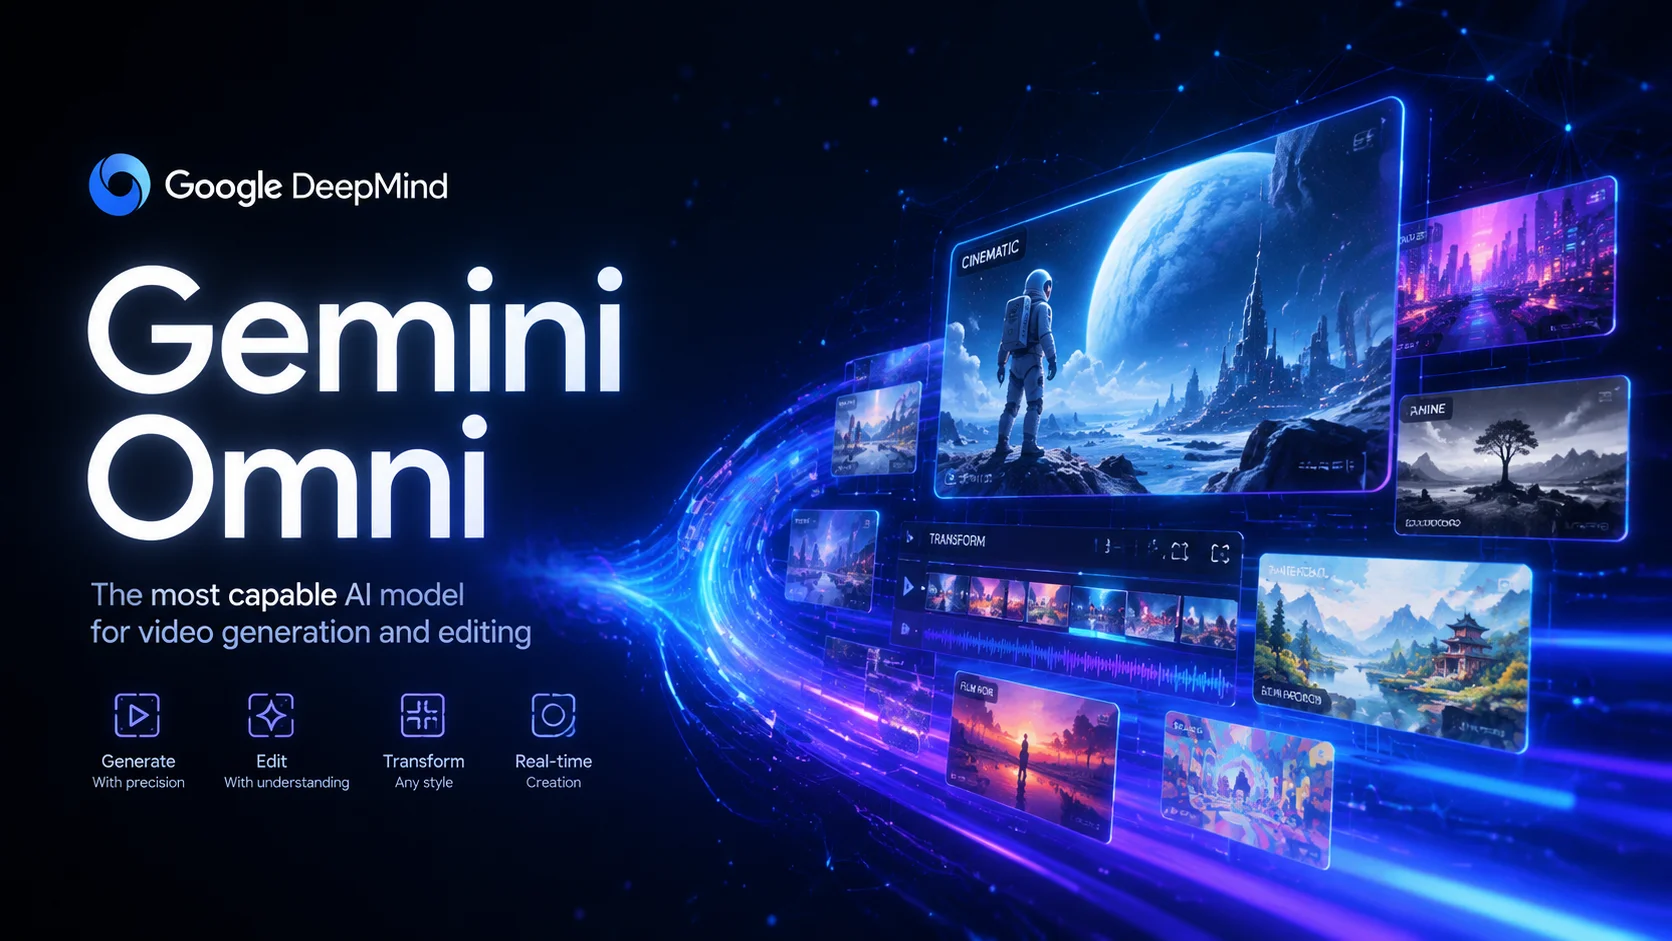
Kluczowe mozliwosci
Multimodalne wejscie, edycja konwersacyjna, transformacja stylu i wiedza o swiecie rzeczywistym — wszystko w jednym modelu
Przegląd kluczowych funkcji
Wieloetapowa edycja konwersacyjna
Gemini Omni wprowadza zasadniczo inne podejscie do edycji wideo. Zamiast zaczynac od zera przy kazdej generacji, mozesz udoskonalac swoje wideo poprzez serie instrukcji w jezyku naturalnym. Zmien tlo, dostosuj akcje, zamien obiekty, przesun kat kamery lub dodaj efekty wizualne — wszystko to utrzymujac reszte wideo w stabilnym stanie. Ten konwersacyjny proces pracy oznacza, ze mozesz iteracyjnie dazac do swojej wizji krok po kroku, tak jak edytowanie dokumentu ze sledzeniem zmian.
Edytuj w wielu etapach: najpierw ustal scene, potem zmien kat kamery, nastepnie dodaj efekty atmosferyczne — utrzymujac spojnosc przez caly czas
Wieloetapowa edycja zachowuje koherencje sceny przy kolejnych modyfikacjach
Najpierw ustal scenę z osobą w pokoju, potem zmień oświetlenie na złotą godzinę, potem dodaj deszcz na oknie — każda edycja opiera się na poprzedniej
Sekwencyjne zmiany środowiska demonstrują konwersacyjne udoskonalanie
Transformacja stylu w czasie rzeczywistym
Gemini Omni potrafi transformowac styl wizualny dowolnego wideo wejsciowego, zachowujac podstawowy ruch, strukture i kompozycje sceny. Opisz docelowa estetyka — metaliczne powierzchnie, reczne szkice, filcowe pacynki, holograficzne projekcje, grafike voxelowa — a model zastosuje transformacje spojnie w kazdej klatce. Oryginalny ruch kamery, akcje postaci i relacje przestrzenne pozostaja nienaruszone, tworzac plynny transfer stylu wykraczajacy daleko poza proste filtry.
Gdy osoba dotyka lustra, spraw, zeby lustro falowalo pieknie jak ciecz, a ramie osoby zamienia sie w odblaskowy material lustrzany
Transformacja stylu zachowuje ruch, jednoczesnie calkowicie zmieniajac estetyka wizualna
Gdy osoba dotyka lustra, całe otoczenie zamienia się w trójwymiarową sztukę voxelową z blokowymi kształtami geometrycznymi
Pełna transformacja otoczenia w sztukę voxelową przy zachowaniu struktury przestrzennej
Prawdziwe multimodalne wejscie
W przeciwienstwie do modeli akceptujacych tylko tekst lub pojedynczy obraz, Gemini Omni moze przetwarzac wiele typow wejscia jednoczesnie. Podaj tekst jako kierunek, obrazy jako referencje wizualna, wideo jako przewodnik ruchu i dzwiek do synchronizacji mowy lub efektow dzwiekowych. Model syntetyzuje wszystkie dane wejsciowe w pojedynczy, spojny wynik wideo. Sprawia to, ze jest praktyczny w rzeczywistych procesach kreatywnych, gdzie inspiracja pochodzi z wielu zrodel — szkic storyboardu, klip referencyjny, nagranie glosowe i opis tekstowy moga wspolnie wplywac na koncowy rezultat.
Dodaj dzwieki harfy zsynchronizowane z momentem dotykania kazdego liscia paproci. Zmien strukture lisci na bioluminescencyjna roslinnosc z latajacymi swietlikami
Laczenie wideo wejsciowego z instrukcjami tekstowymi i referencja audio dla zsynchronizowanego wyniku
Zwizualizuj proces fałdowania białek wykorzystując rzeczywistą wiedzę naukową, renderowany w stylu claymation z dokładnym zachowaniem molekularnym
Wiedza ze świata rzeczywistego zastosowana do wizualizacji naukowej z kreatywnym stylem
Czesto zadawane pytania
Gemini Omni FAQ
Co tworcy mowia o Gemini Omni
"Wieloetapowa edycja to cos, co wyroznia Gemini Omni. Moge udoskonalac scene krok po kroku zamiast regenerowac wszystko od zera za kazdym razem. To naprawde przypomina rezyserowanie, a nie promptowanie."
Elena Vasquez
Dyrektor kreatywny
"Wieloetapowa edycja to cos, co wyroznia Gemini Omni. Moge udoskonalac scene krok po kroku zamiast regenerowac wszystko od zera za kazdym razem. To naprawde przypomina rezyserowanie, a nie promptowanie."
Elena Vasquez
Dyrektor kreatywny
Odkryj Więcej Modeli Wideo AI


Zacznij tworzyc z Gemini Omni
 +1k