AI 一致角色生成器
用AI 一致角色生成器让同一个角色在漫画分镜、品牌 IP、故事板和多场景海报里保持脸、发型、服装和身份一致。它更关注适合先锁定角色设定,再批量测试姿势、镜头和剧情画面,适合直接用于内容、电商或个人资料场景。
用AI 一致角色生成器让同一个角色在漫画分镜、品牌 IP、故事板和多场景海报里保持脸、发型、服装和身份一致。它更关注适合先锁定角色设定,再批量测试姿势、镜头和剧情画面,适合直接用于内容、电商或个人资料场景。
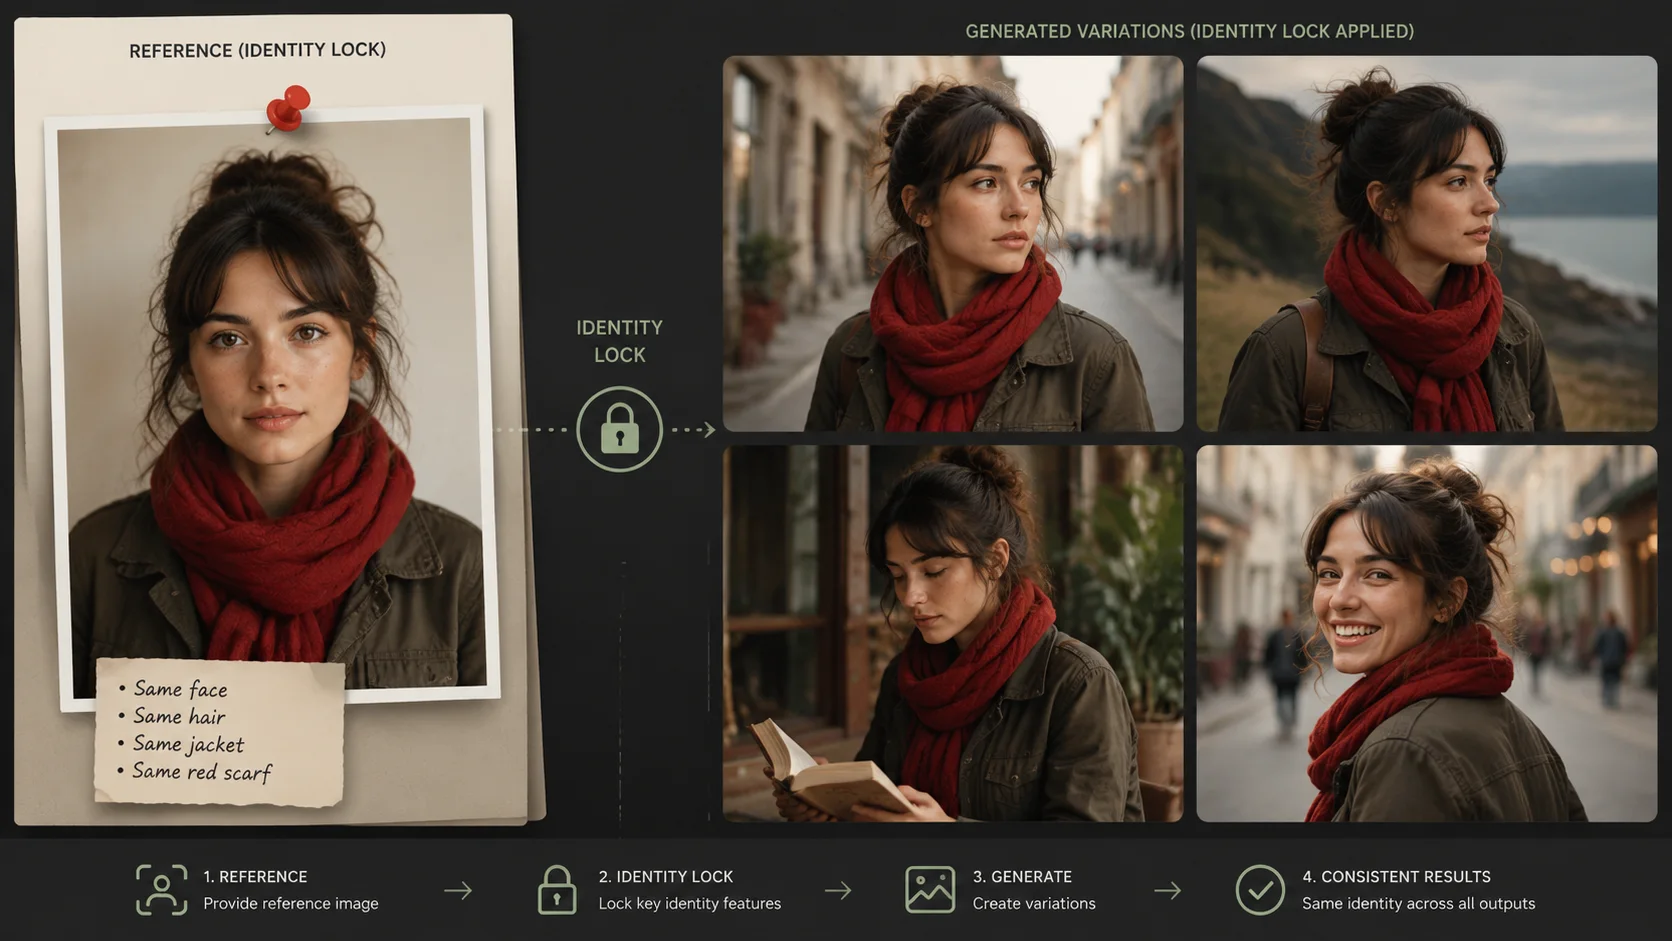
工具会优先保留脸型、眼距、发型、体型和服装要点,再让每一格进入不同姿势或环境。
故事、品牌、奇幻和生活场景对应不同用途,不是随机生成几张好看的头像。
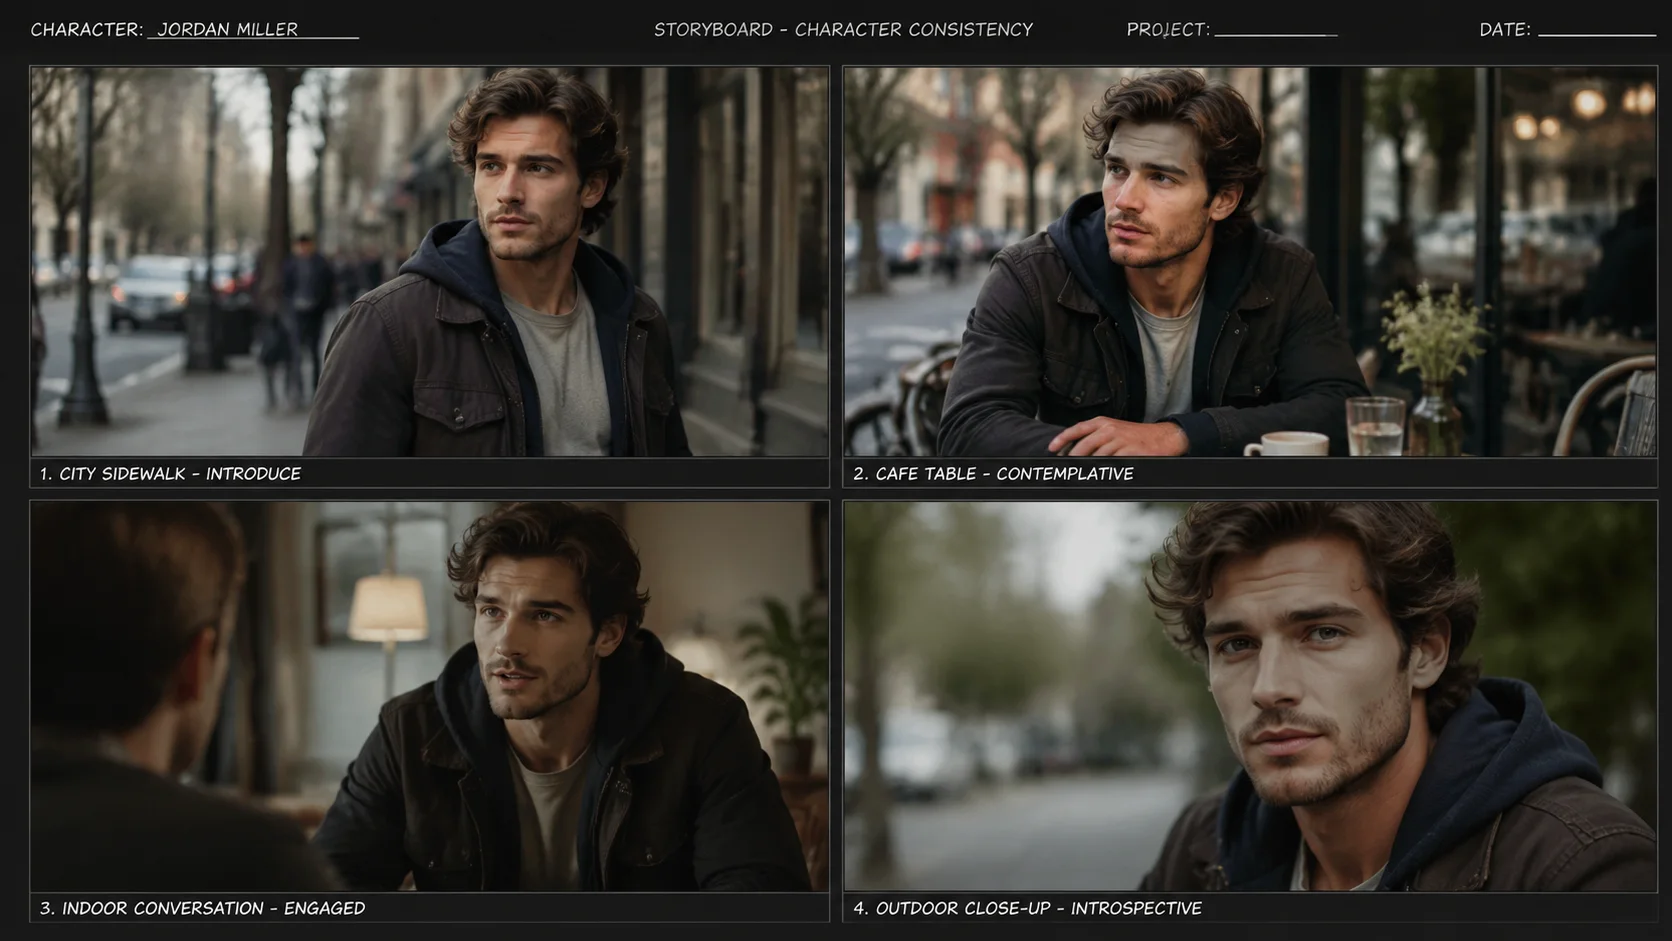
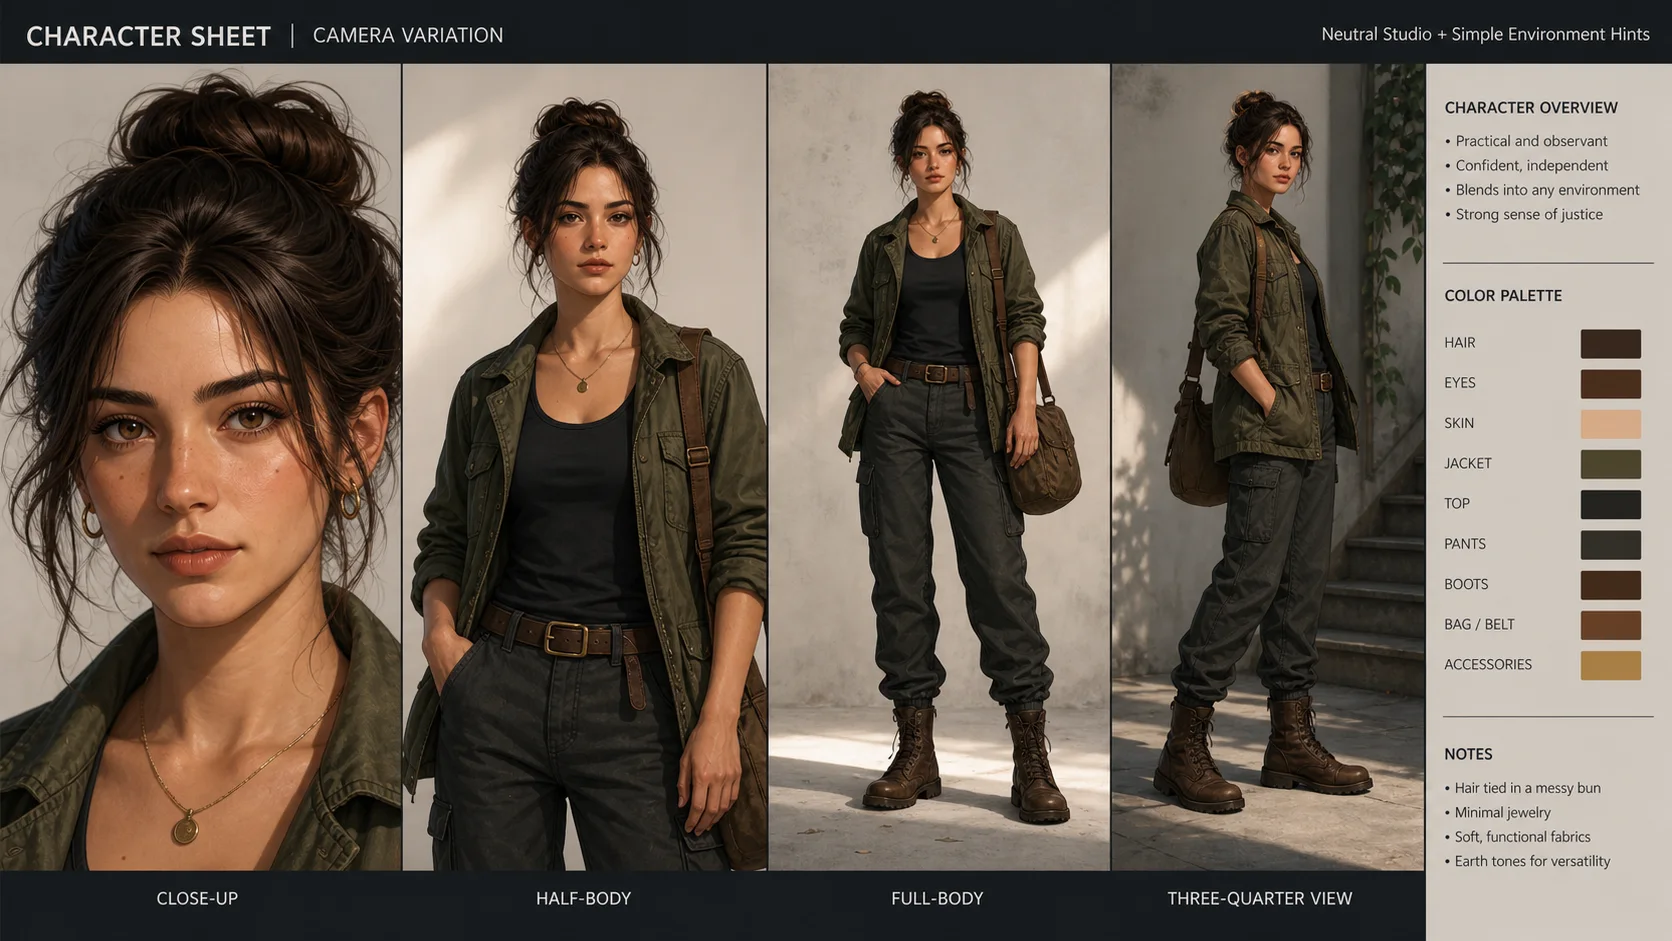
混合镜头适合快速预览,肖像镜头适合头像,设定镜头适合角色设定。
侧脸、遮挡、复杂手部和过小脸部仍然容易漂移,发布前要放大检查。
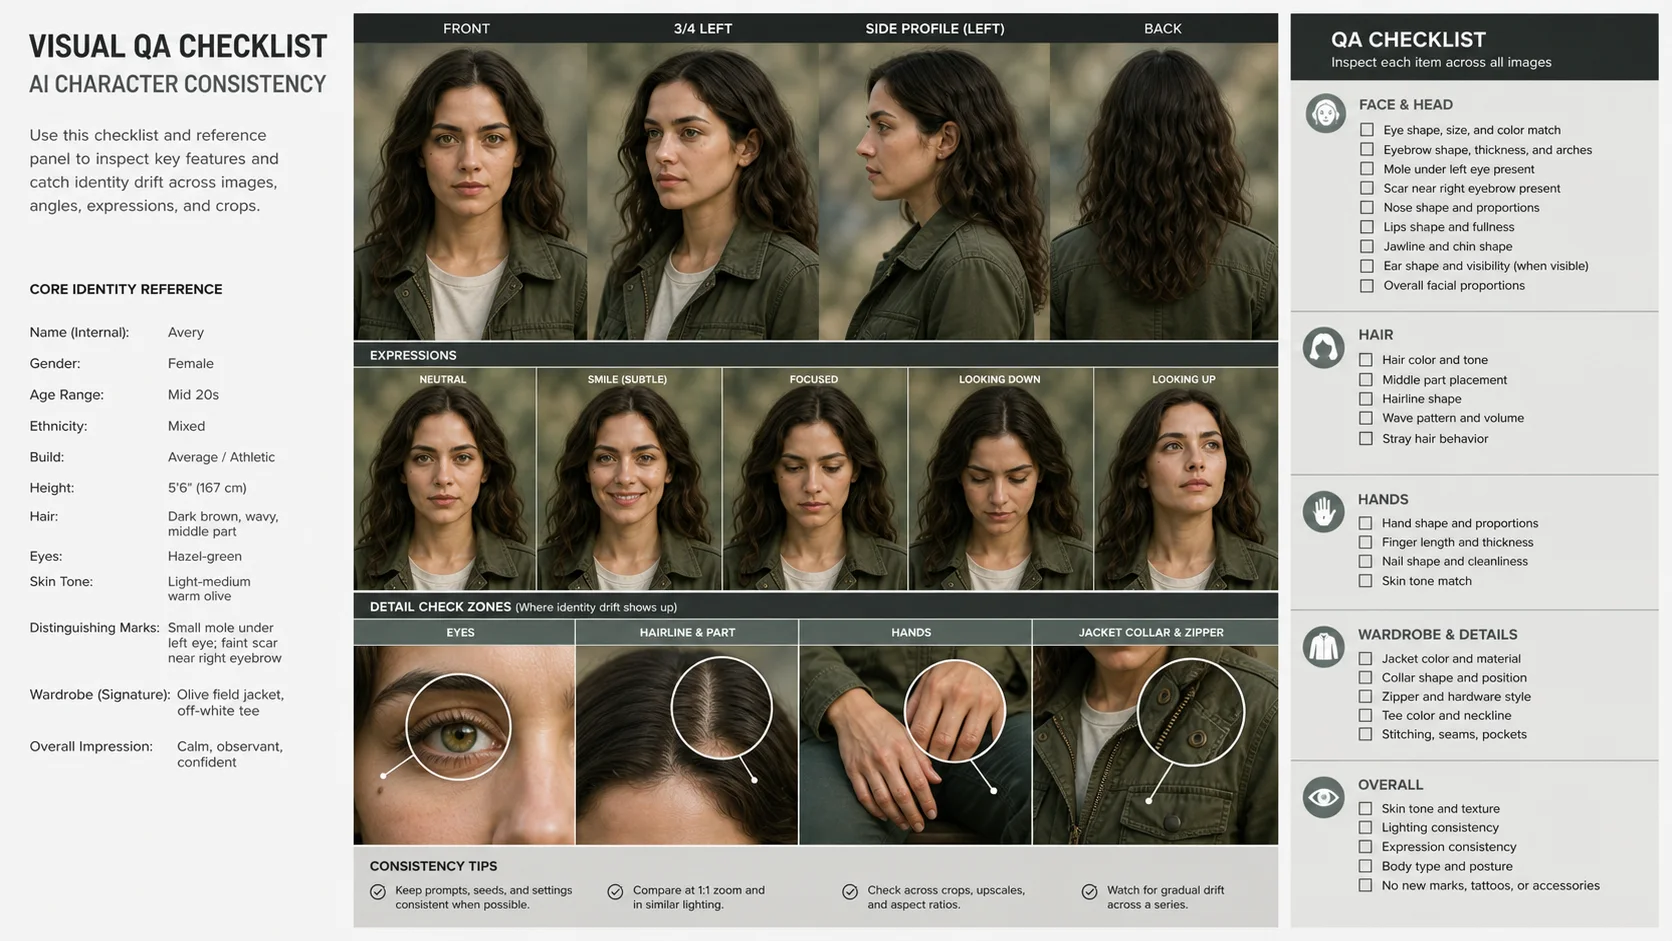
"把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。"
把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。
"把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。"
把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。
"把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。"
把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。
"把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。"
把一张参考图变成同一角色多镜头角色板,适合分镜、头像、漫画和品牌视觉测试。
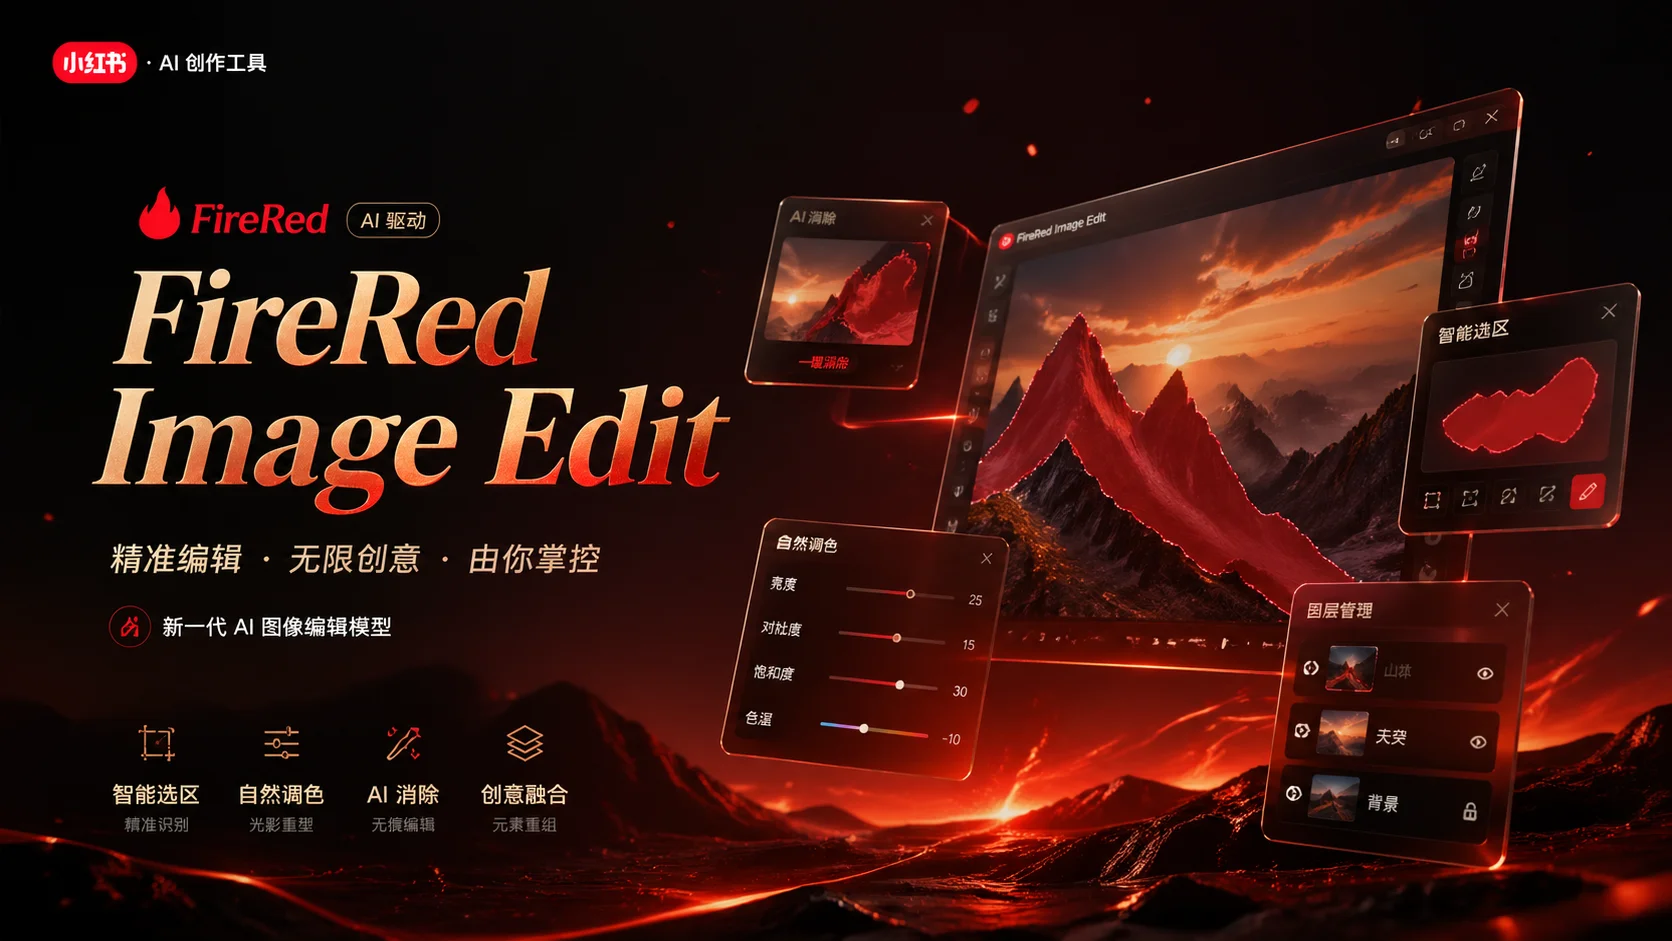
小红书 FireRed 团队开源的指令驱动AI图像编辑模型 — 覆盖添加、移除、替换、背景、风格化、文字、修复、人像妆容、多图融合、虚拟试穿10大编辑能力。基于 Diffusion Transformer 架构,原生支持中英双语指令。...
支持最多16张参考图与3000字符长提示词,适合高一致性图像生成、品牌物料和复杂场景创作
支持 4K 超高清输出和完美提示词理解的专业级 AI 图像生成器

具备原生音频生成和真实物理渲染能力的专业级 AI 视频生成器
OpenAI最先进的通用视频生成模型——从文本提示词和图像创建高质量视频,具备逼真的物理效果、富有表现力的角色和电影级视觉叙事。在 GPT Image 2.5 体验。
字节跳动新一代AI视频模型,搭载革命性的 @-reference 系统。将文字、图片、视频片段和音频融合在单一提示词中。原生音视频同步、V2V编辑、最高2K分辨率30fps输出——全部在统一的生成流程中完成。
 10,000+