Seedance 2.0
字节跳动新一代AI视频模型,搭载革命性的 @-reference 系统。将文字、图片、视频片段和音频融合在单一提示词中。原生音视频同步、V2V编辑、最高2K分辨率30fps输出——全部在统一的生成流程中完成。
关于 Seedance 2.0
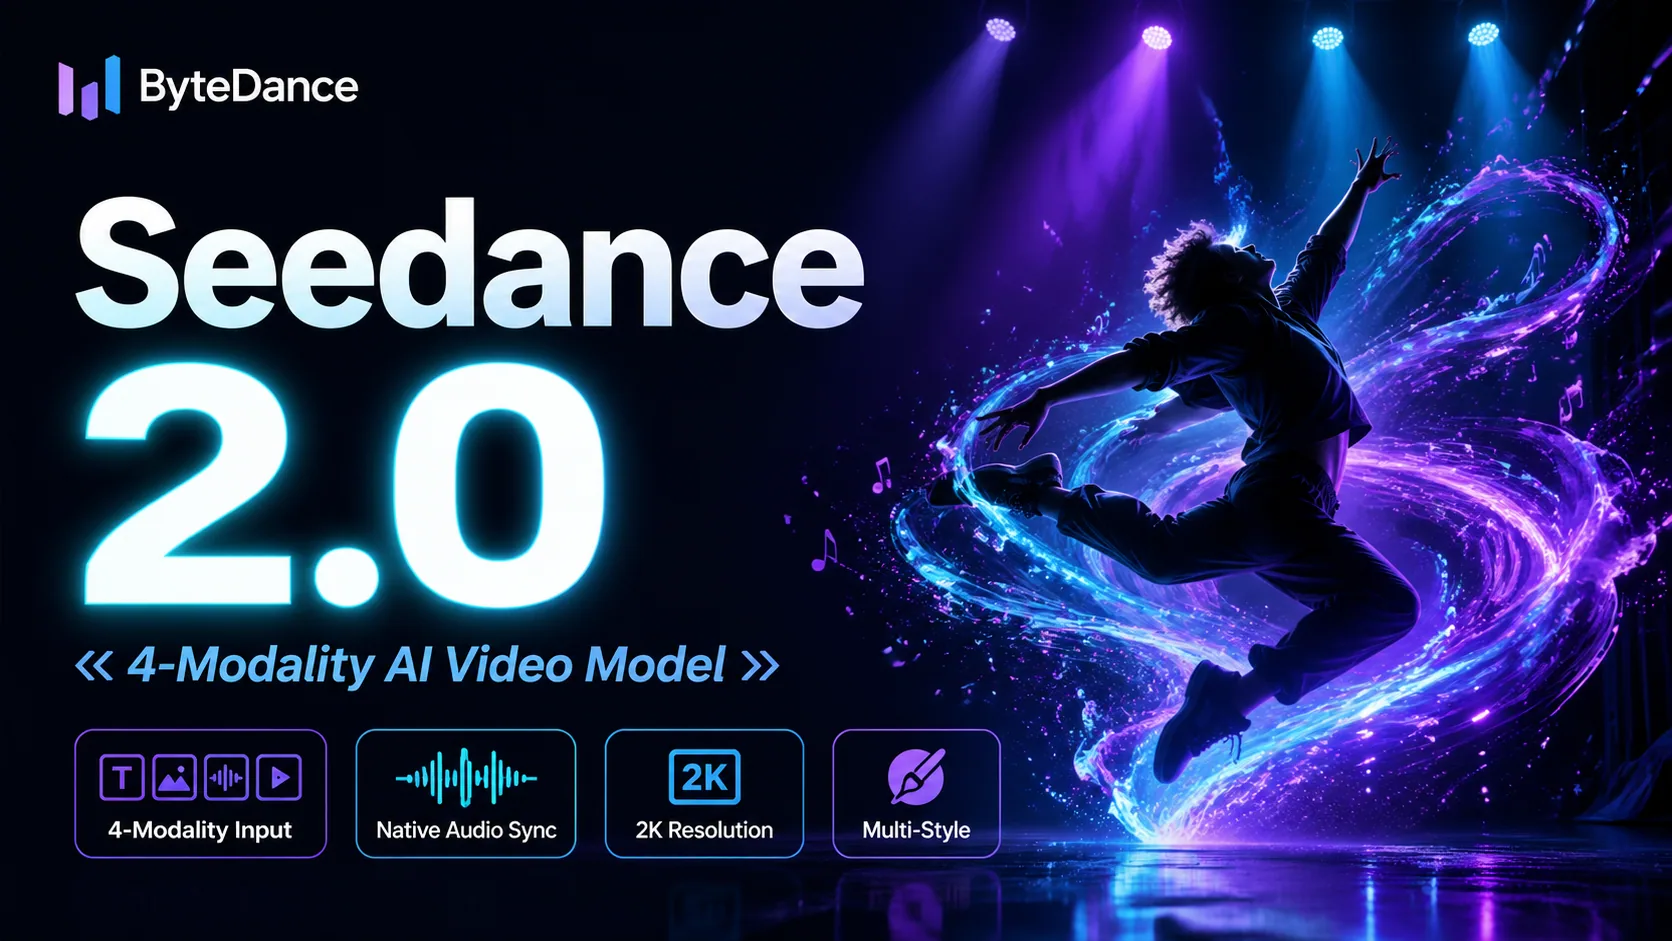
Seedance 2.0 是字节跳动最先进的AI视频生成模型,于2026年2月发布。它采用统一的多模态音视频联合生成架构,同时支持4种输入模态——文字、最多9张图片、最多3段视频片段和最多3条音轨。开创性的 @-reference 系统让您可以在提示词中标记特定元素,并将其绑定到上传的参考素材,实现对镜头运动、角色外观、音频节奏和视觉风格的精细控制。输出最高可达2K分辨率,并配备原生同步音频,包括多语言口型同步、音效和背景音乐。
Seedance 2.0 核心功能
@-Reference 系统
在提示词中使用 @Image、@Video 和 @Audio 标签进行革命性的参考标记。将特定元素绑定到上传的文件,精确控制镜头运动、角色动作、音频节奏和视觉风格。
4模态输入
在单个生成请求中同时使用文字、最多9张图片、最多3段视频片段和最多3条音轨。Seedance 2.0 是首个能同时处理全部四种输入类型的模型。
原生音视频同步
联合音视频合成技术生成与视觉输出同步的口型对话、音效和背景音乐。支持音素级别的多语言口型同步,精准度极高。
V2V 视频编辑
通过参考转视频模式编辑现有视频。从上传的片段中迁移运动模式、镜头轨迹和节奏。在保留原始结构的前提下更换服装、调整动作或替换元素。
2K分辨率与30fps
原生2K(2048×1080)输出,30fps,提供多种质量级别:480p、720p和1080p。每次生成时长为4至15秒。
多镜头角色一致性
从不同角度上传同一角色的多张参考图片。Seedance 2.0 能够在多个生成的片段中保持面部、服装、身体比例和配饰的一致性。
官方展示
探索 Seedance 2.0 在多模态参考控制、原生音频生成和视频编辑方面的强大能力

“@Image1 走过 @Image2,镜头运动来自 @Video1,背景音乐来自 @Audio1”
结合所有模态的多重参考提示词

“@Image1 角色跟随 @Audio1 的节奏在 @Image3 环境中跳舞”
角色动作由音频节拍参考引导

“一个人进行演示演讲,配有同步的英语语音和幻灯片切换”
口型同步对话配合视觉内容

“烹饪教程,配有逐步旁白和厨房环境音”
旁白与烹饪动作同步
Seedance 2.0 常见问题
Seedance 2.0 FAQ
创作者对 Seedance 2.0 的评价
"@-reference 系统是真正的革命性创新。我可以从参考片段中提取镜头运动并即时应用——这是一种全新的创作工作流。"
Alex Kim
视频导演
"4模态输入是一个颠覆性的改变。我可以将角色设计、镜头运动参考和背景音乐全部放入一个提示词中,得到完全符合预期的结果。"
Yuki Tanaka
动态设计师
"@-reference 系统是真正的革命性创新。我可以从参考片段中提取镜头运动并即时应用——这是一种全新的创作工作流。"
Alex Kim
视频导演
"4模态输入是一个颠覆性的改变。我可以将角色设计、镜头运动参考和背景音乐全部放入一个提示词中,得到完全符合预期的结果。"
Yuki Tanaka
动态设计师
探索更多AI视频模型


 +1k