AI 一致角色生成器
用AI 一致角色生成器令同一角色喺漫畫分鏡、品牌 IP、故事板同多場景海報入面保持樣貌、髮型、服裝同身份一致。佢更重視先鎖定角色設定,再測試姿勢、鏡頭同劇情畫面,適合直接用喺內容、網店或者個人資料場景。
用AI 一致角色生成器令同一角色喺漫畫分鏡、品牌 IP、故事板同多場景海報入面保持樣貌、髮型、服裝同身份一致。佢更重視先鎖定角色設定,再測試姿勢、鏡頭同劇情畫面,適合直接用喺內容、網店或者個人資料場景。
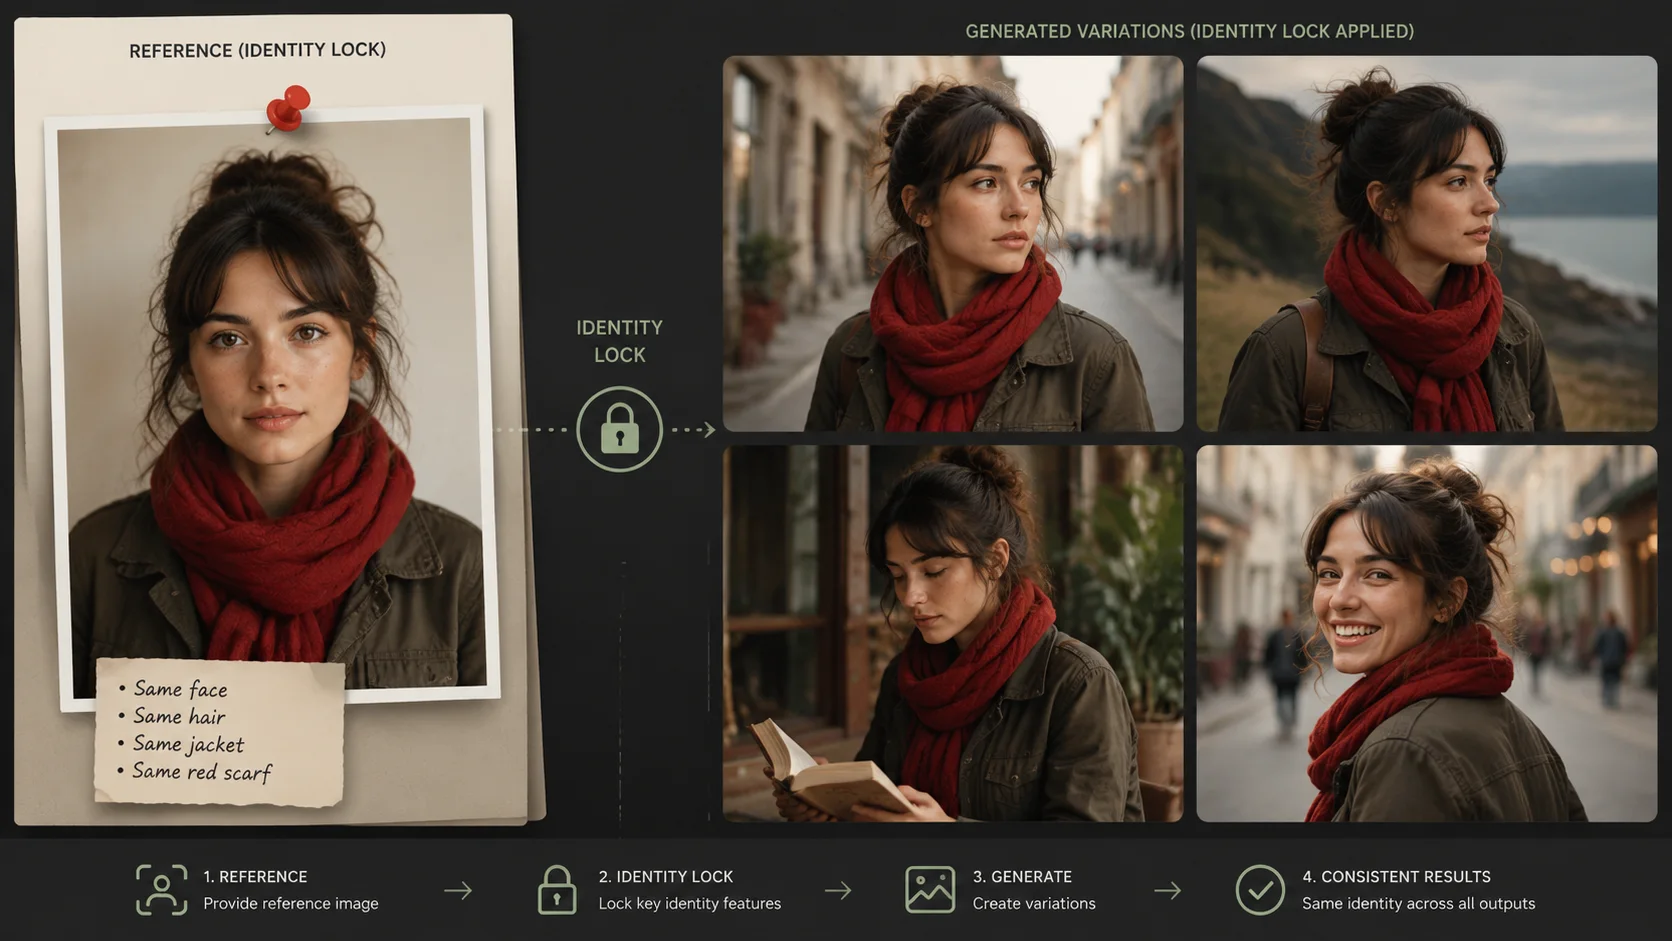
工具會優先保留臉型、眼距、髮型、體型和服裝要點,再讓每一格進入不同姿勢或環境。
故事、品牌、奇幻和生活場景對應不同用途,不是隨機生成幾張好看的頭像。
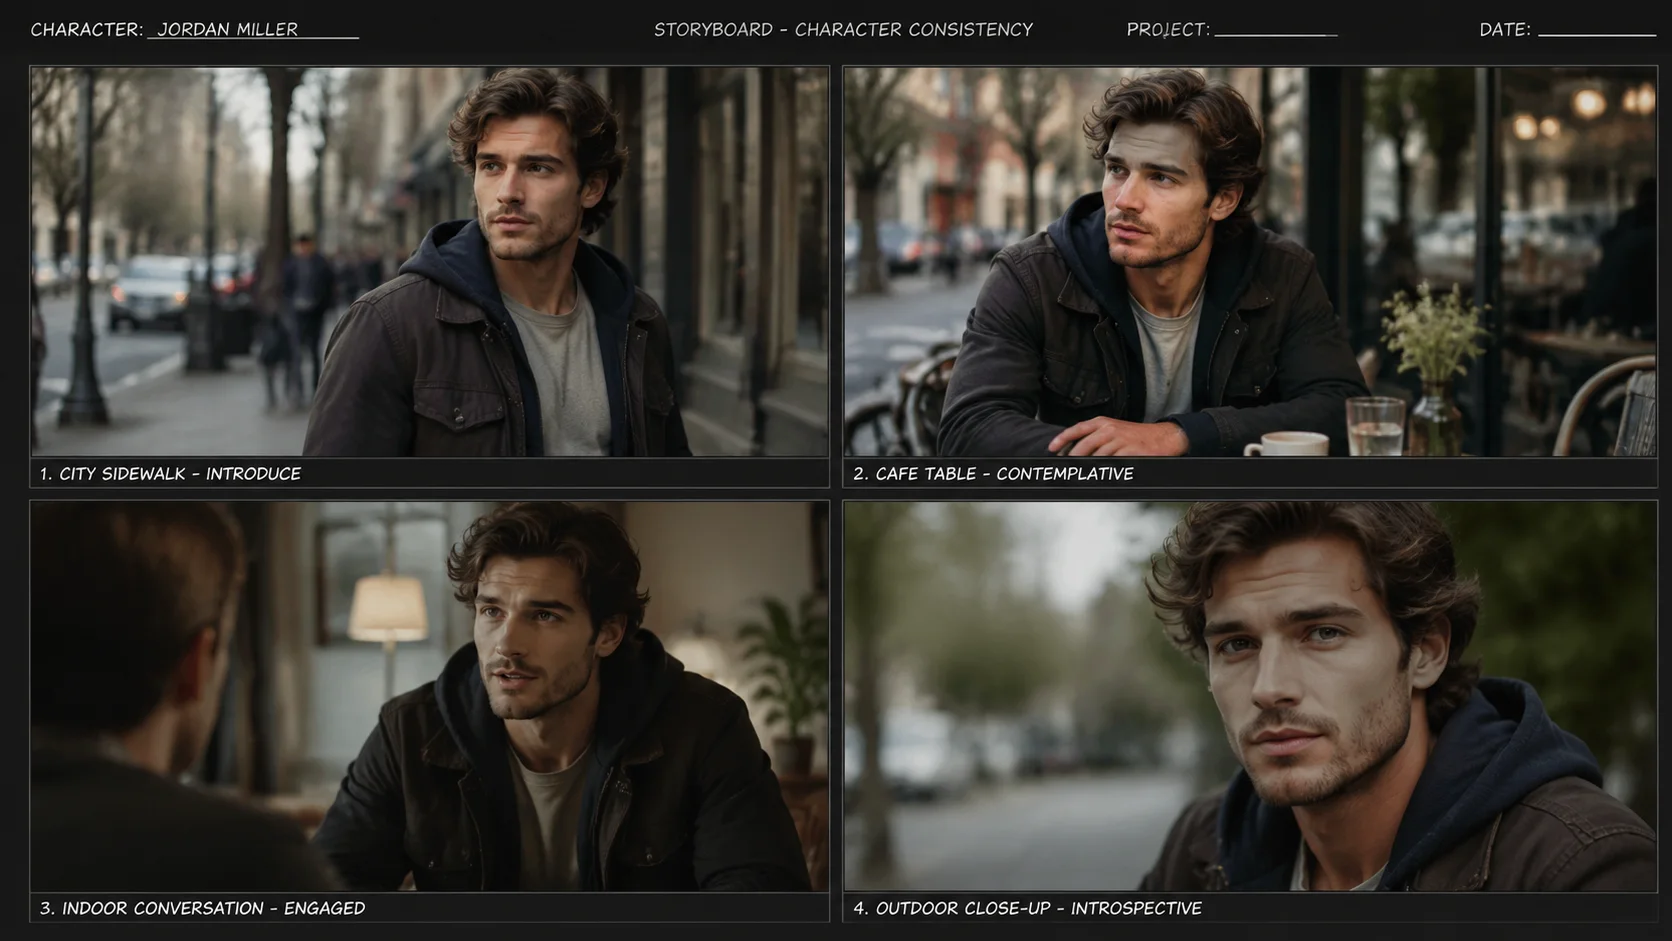
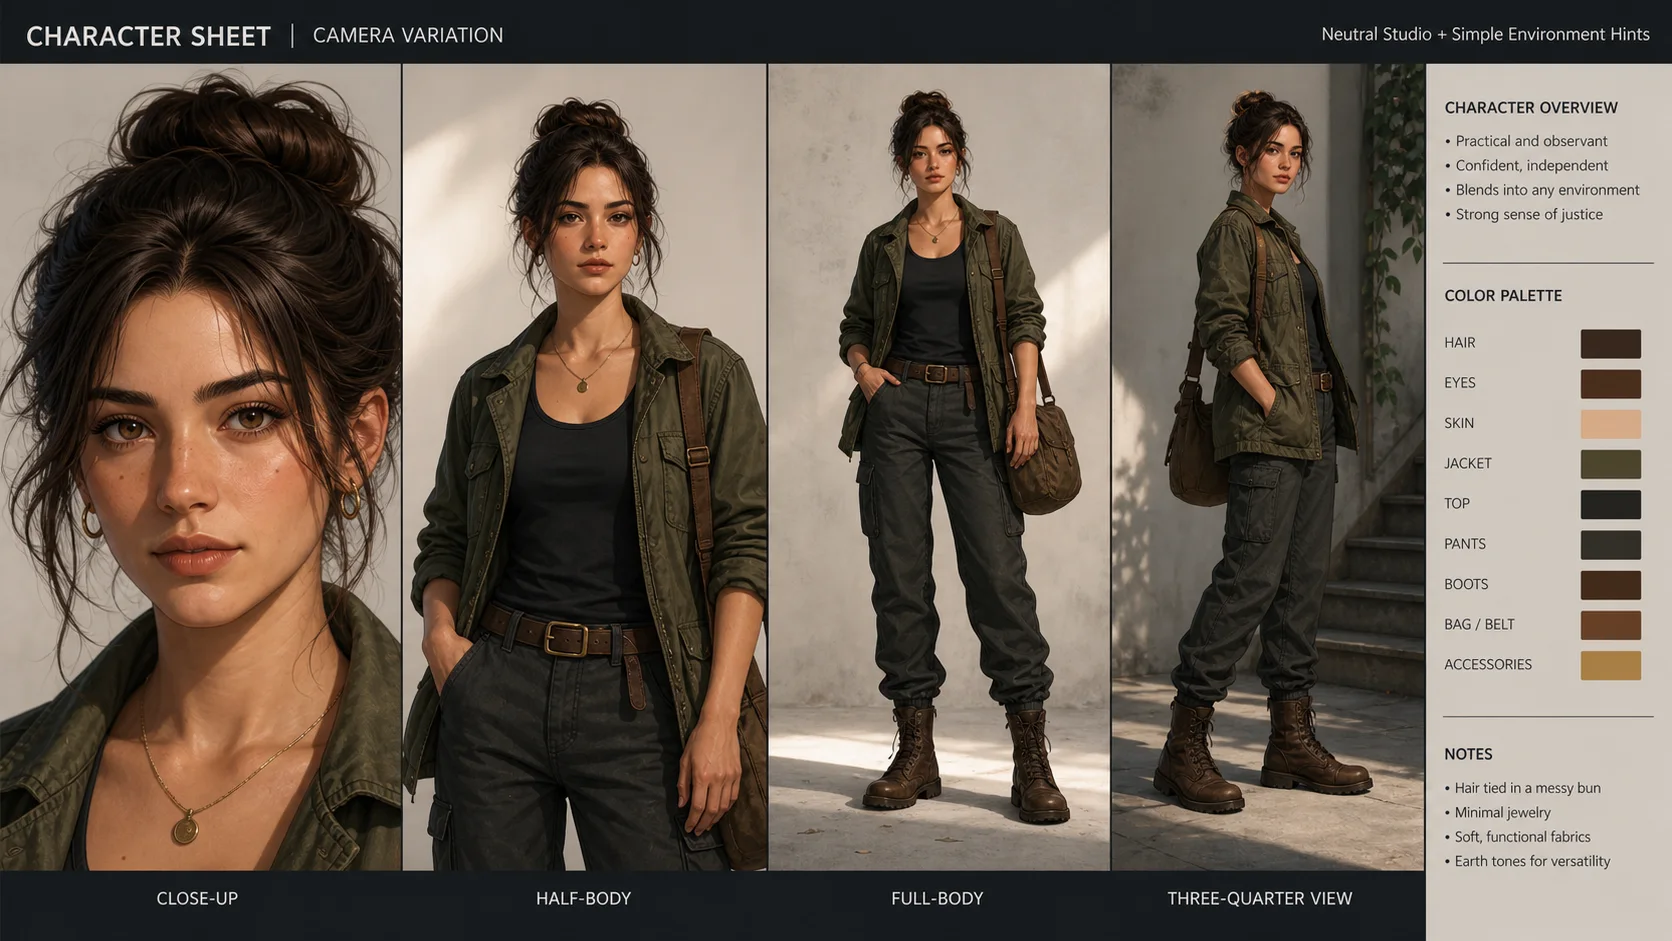
混合鏡頭適合快速預覽,肖像鏡頭適合頭像,設定鏡頭適合角色設定。
側臉、遮擋、複雜手部和過小臉部仍然容易漂移,發布前要放大檢查。
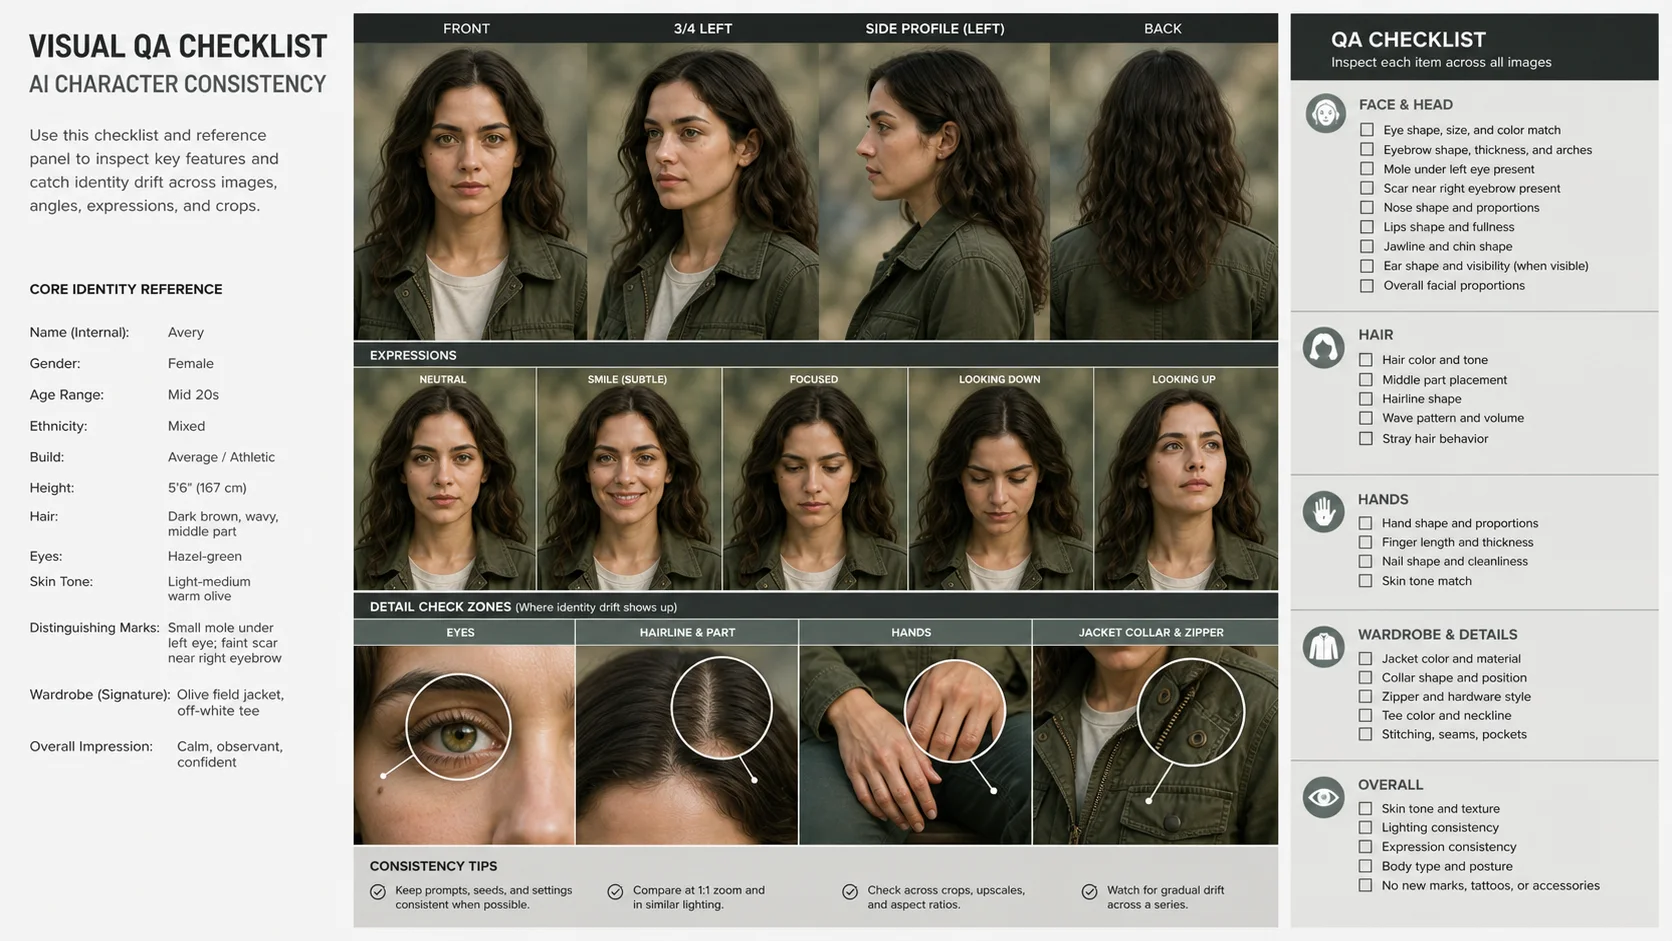
"把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。"
把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。
"把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。"
把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。
"把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。"
把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。
"把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。"
把一張參考圖變成同一角色多鏡頭角色板,適合分鏡、頭像、漫畫和品牌視覺測試。
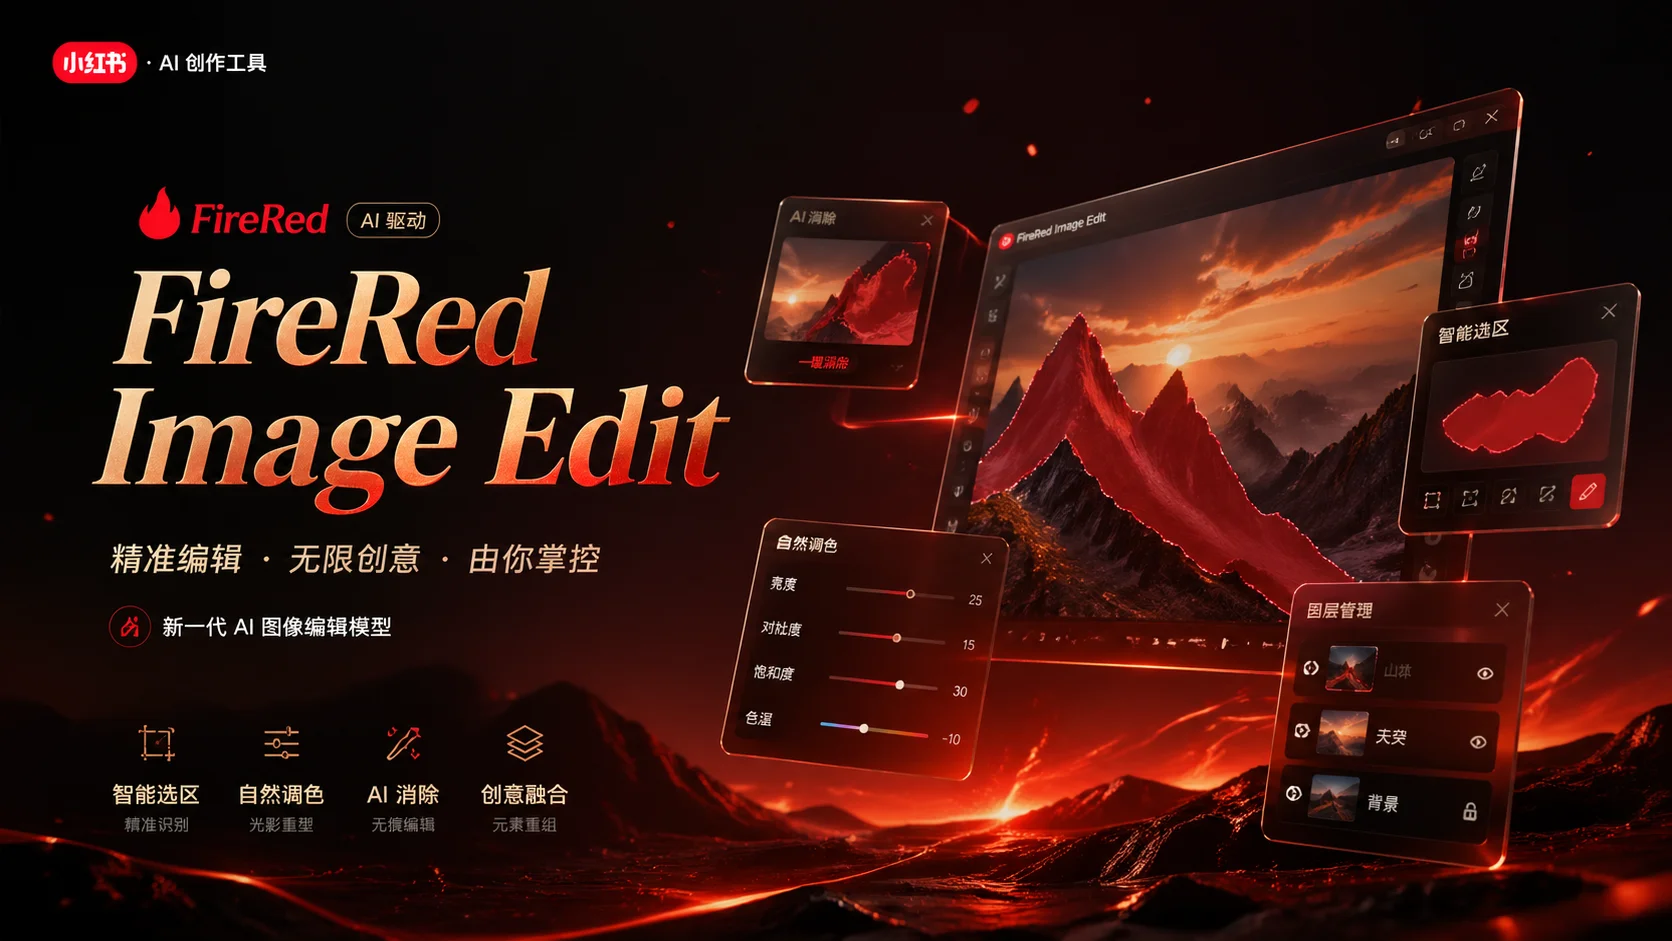
小紅書 FireRed 團隊開源嘅指令驅動AI圖像編輯模型 — 涵蓋添加、移除、替換、背景、風格化、文字、修復、人像妝容、多圖融合、虛擬試穿10大編輯能力。基於 Diffusion Transformer 架構,原生支援中英雙語指令。...
支援最多16張參考圖與3000字元長提示詞,適合高一致性圖像生成、品牌素材與複雜創意工作流
支援 4K 超高清輸出和完美提示詞理解的專業級 AI 圖像生成器

專業AI視頻生成器,具有原生音頻生成和逼真物理渲染
OpenAI最先進的通用影片生成模型——從文字提示詞和圖像建立高品質影片,具備逼真的物理效果、富有表現力的角色和電影級視覺敘事。在 GPT Image 2.5 免費體驗!
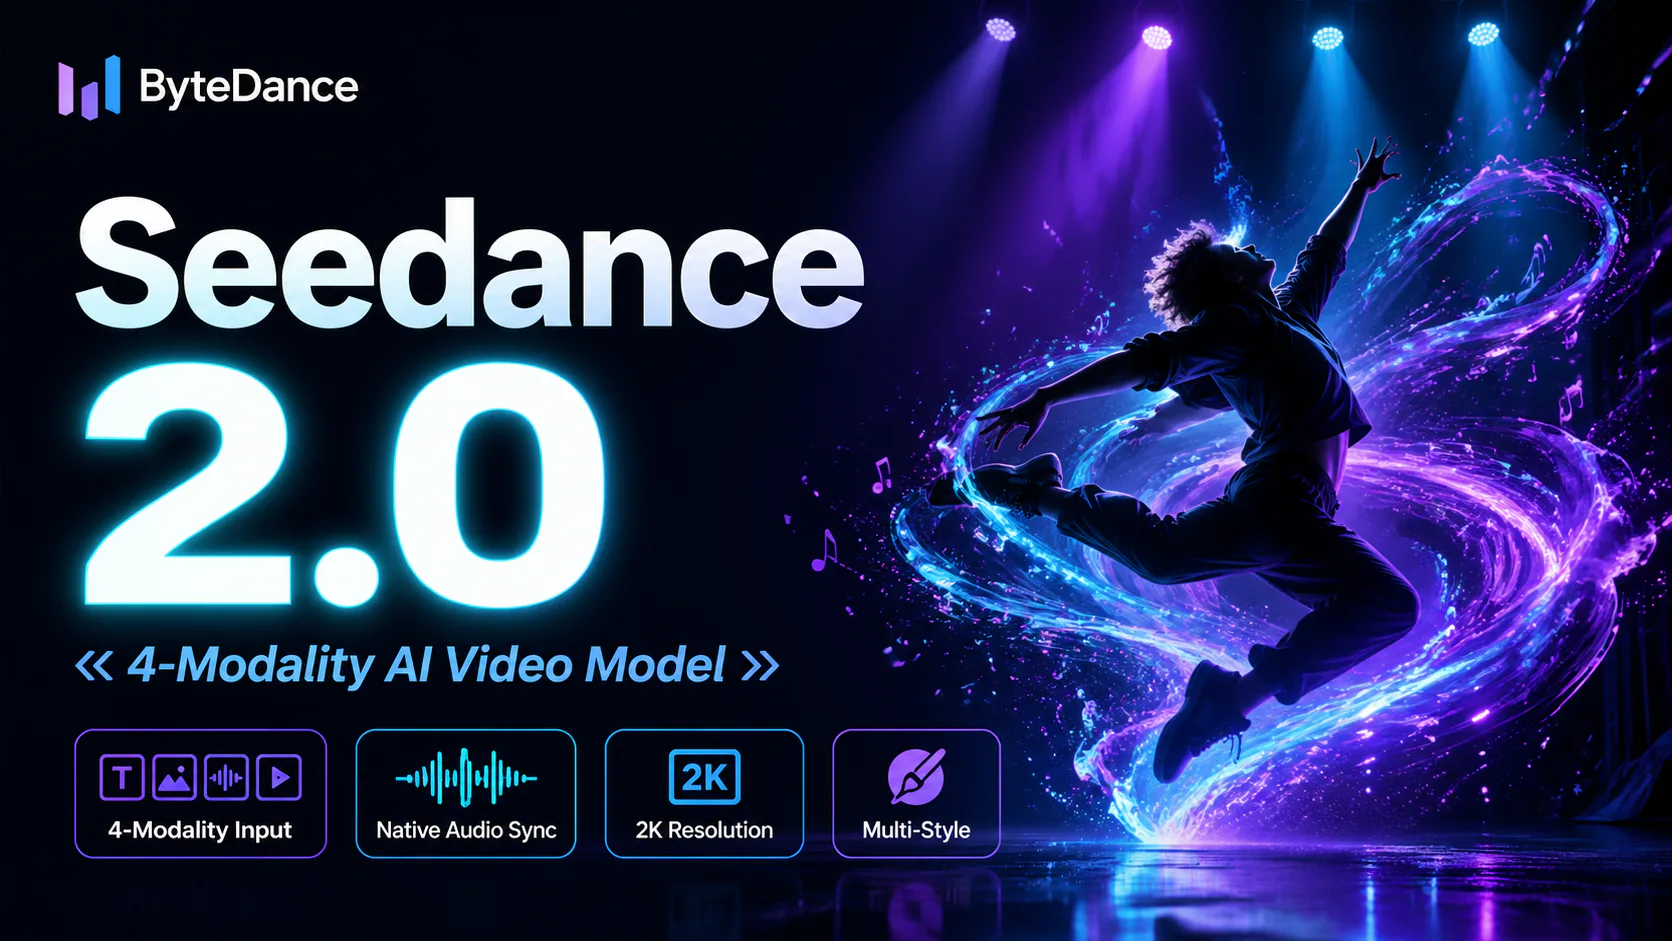
ByteDance 新一代 AI 影片模型,配備革命性 @-reference 系統。將文字、圖片、影片剪輯同音訊結合成單一提示。原生音畫同步、V2V 編輯功能,以及最高 2K 解像度 @ 30fps — 全部喺統一生成過程中完成。
 10,000+