AI漫画翻译器
自动检测并翻译漫画中的文字,保持原始画风不变。
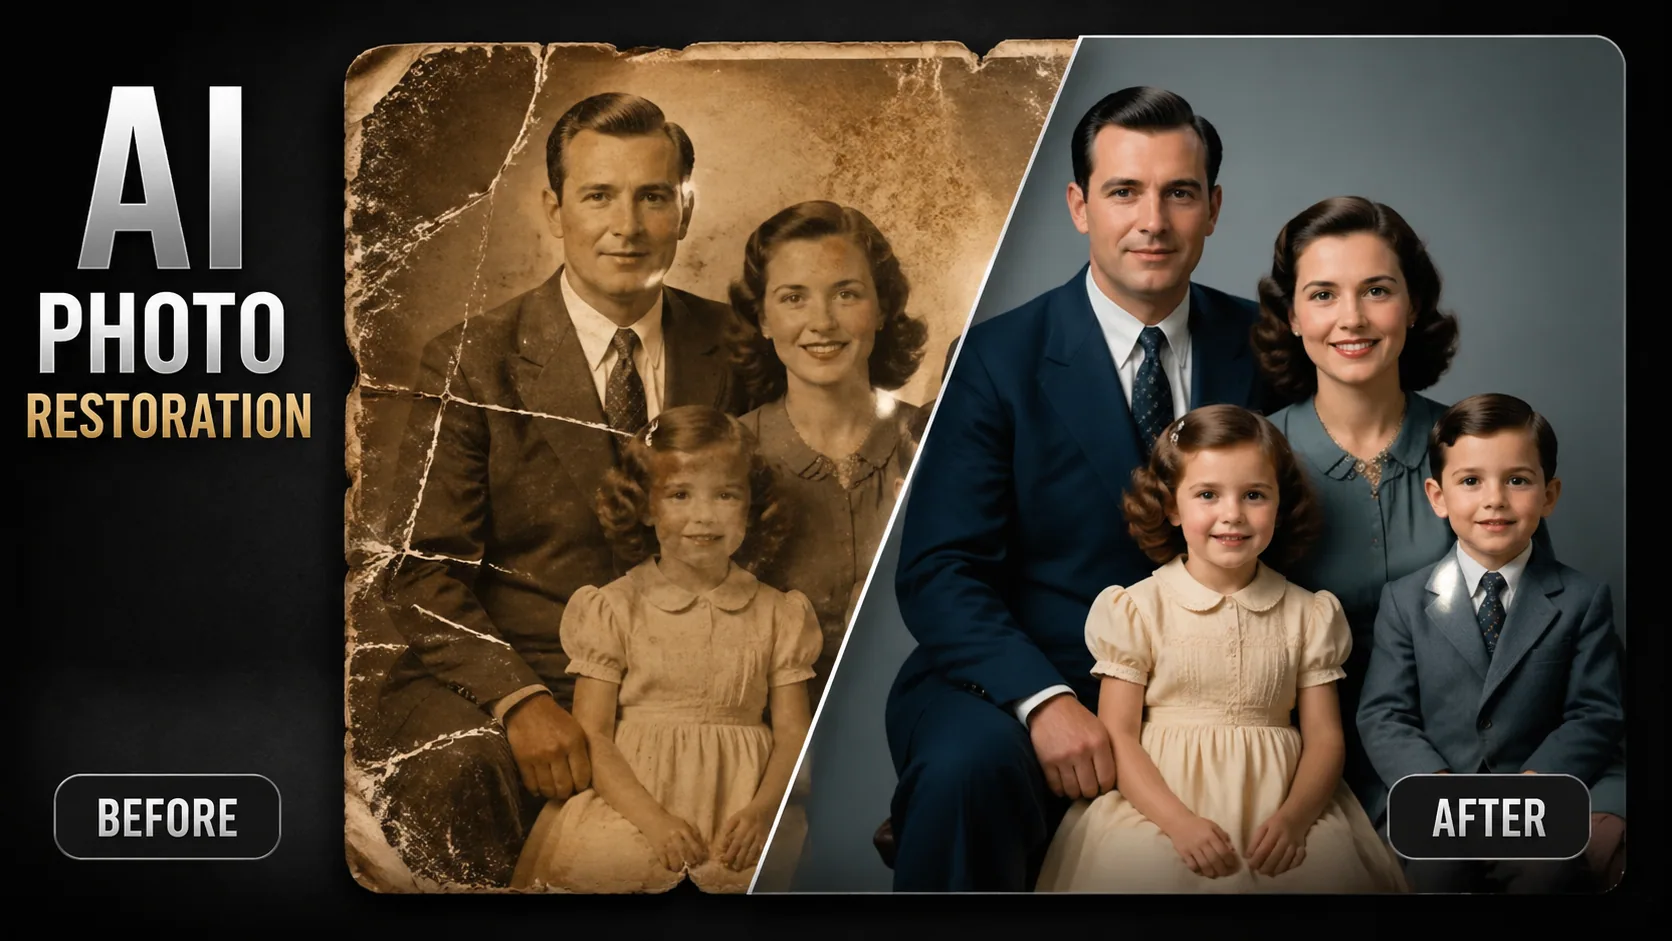
自动检测并翻译漫画中的文字,保持原始画风不变。
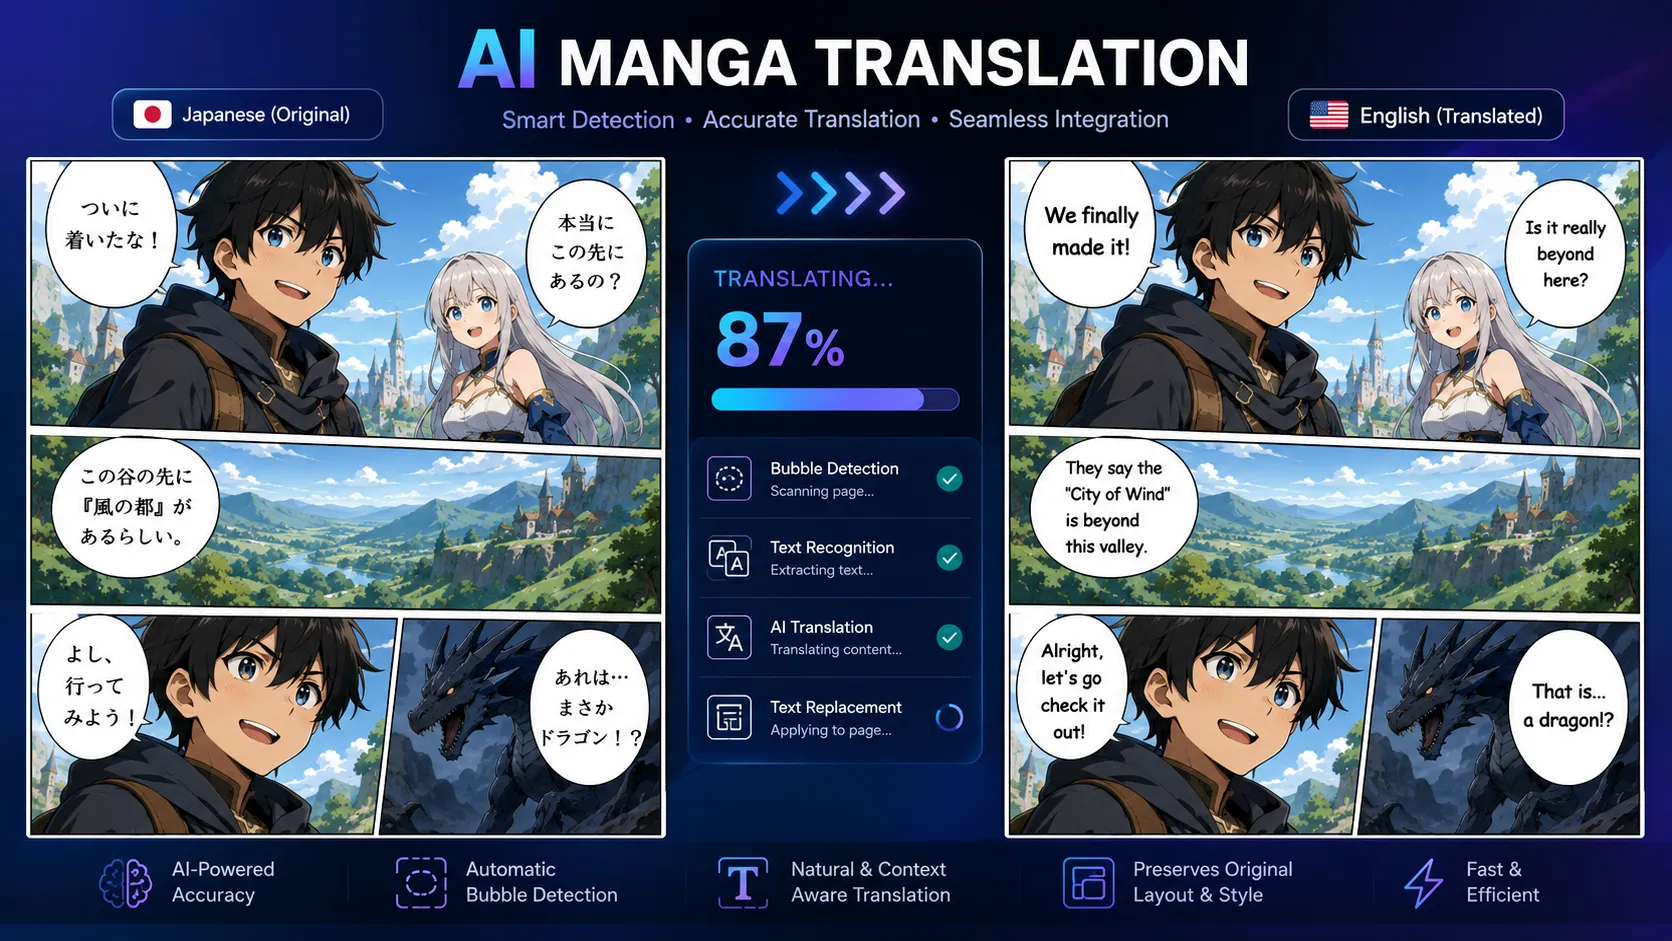
AI自动识别页面上的每个对话气泡、旁白框和音效文字——无需手动选择。然后根据上下文翻译检测到的文字,理解漫画特有的表达方式、敬语和文化背景,提供自然流畅、保留原意的翻译。
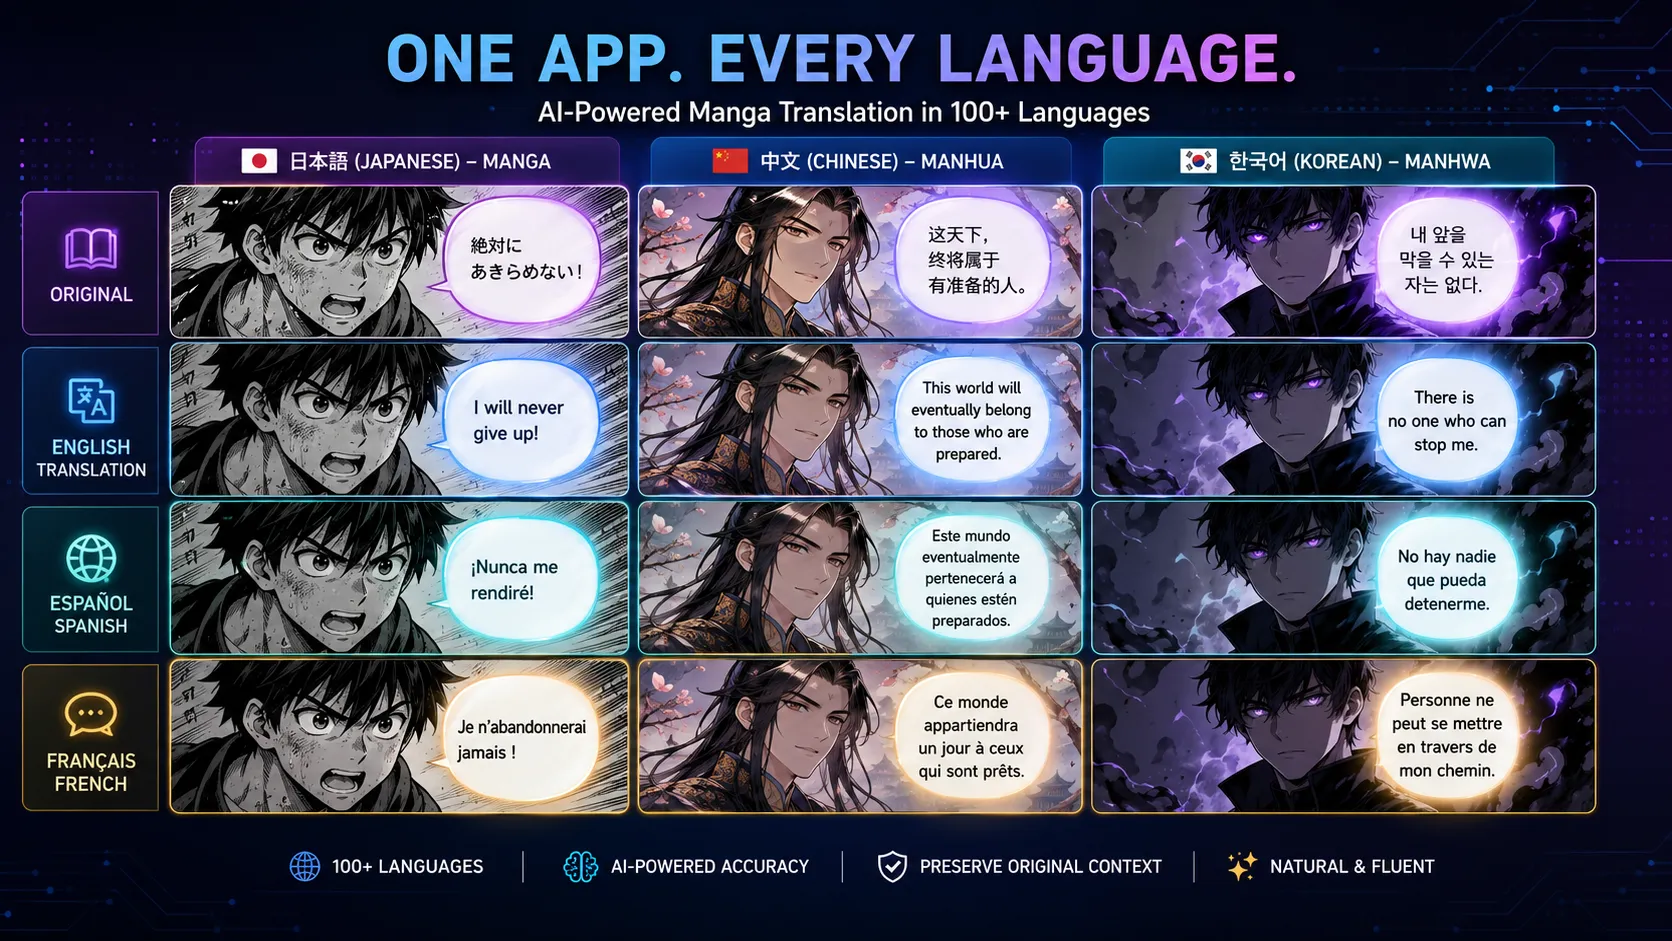
支持日语、中文、韩语、英语、西班牙语、法语、德语等数十种语言互译。无论您阅读的是日本漫画、韩国网漫还是中国漫画,AI都能无缝处理竖排和横排文字、从右到左的阅读顺序以及各语言特有的排版规范。
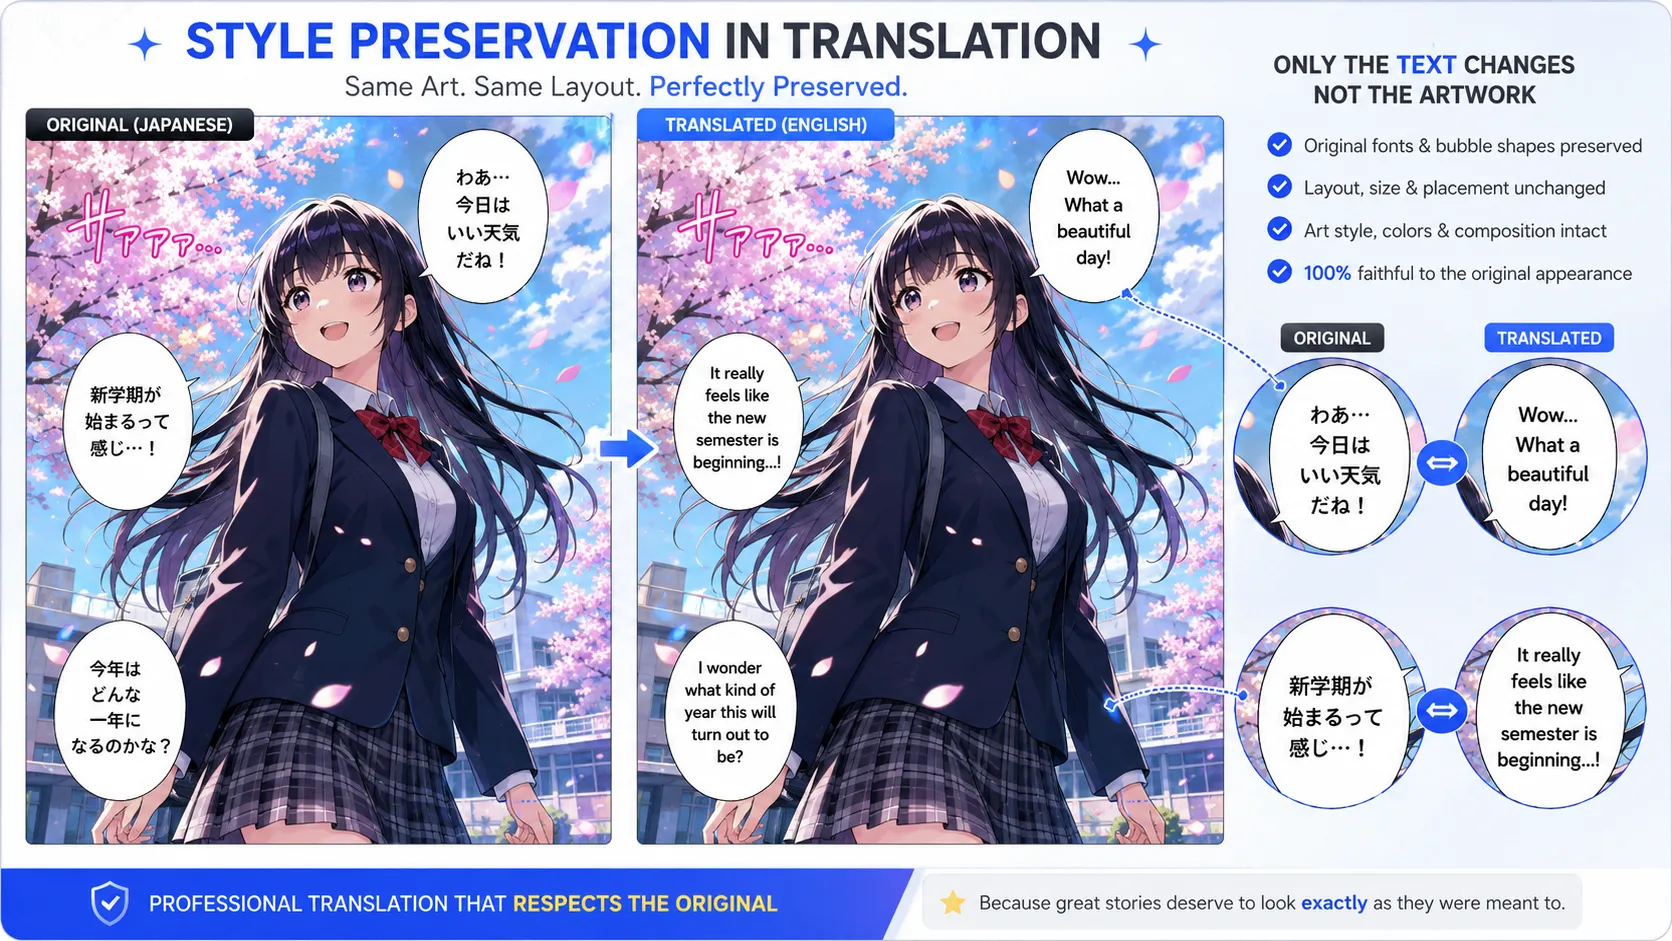
翻译后的文字直接渲染到图片上,字体风格与原文匹配——粗细、大小和间距都完美保持。所有原始画作、线稿、颜色和背景完全不受影响。最终效果如同专业排版的官方翻译,而非机器生成的覆盖层。
对白优先时先翻译;网点很密、拟声词手写或文字压在画面上时,发布前仍要人工检查。
"终于可以不用等汉化组就能看生肉日漫了,翻译质量让我惊喜。"
漫画读者
"我用它对比日文原版和中文翻译,是很好的日语学习工具!"
语言学习者
"90年代没有汉化的老漫画终于能看懂了,AI对低分辨率扫描图的处理也很好。"
漫画收藏家
"终于可以不用等汉化组就能看生肉日漫了,翻译质量让我惊喜。"
漫画读者
"我用它对比日文原版和中文翻译,是很好的日语学习工具!"
语言学习者
"90年代没有汉化的老漫画终于能看懂了,AI对低分辨率扫描图的处理也很好。"
漫画收藏家
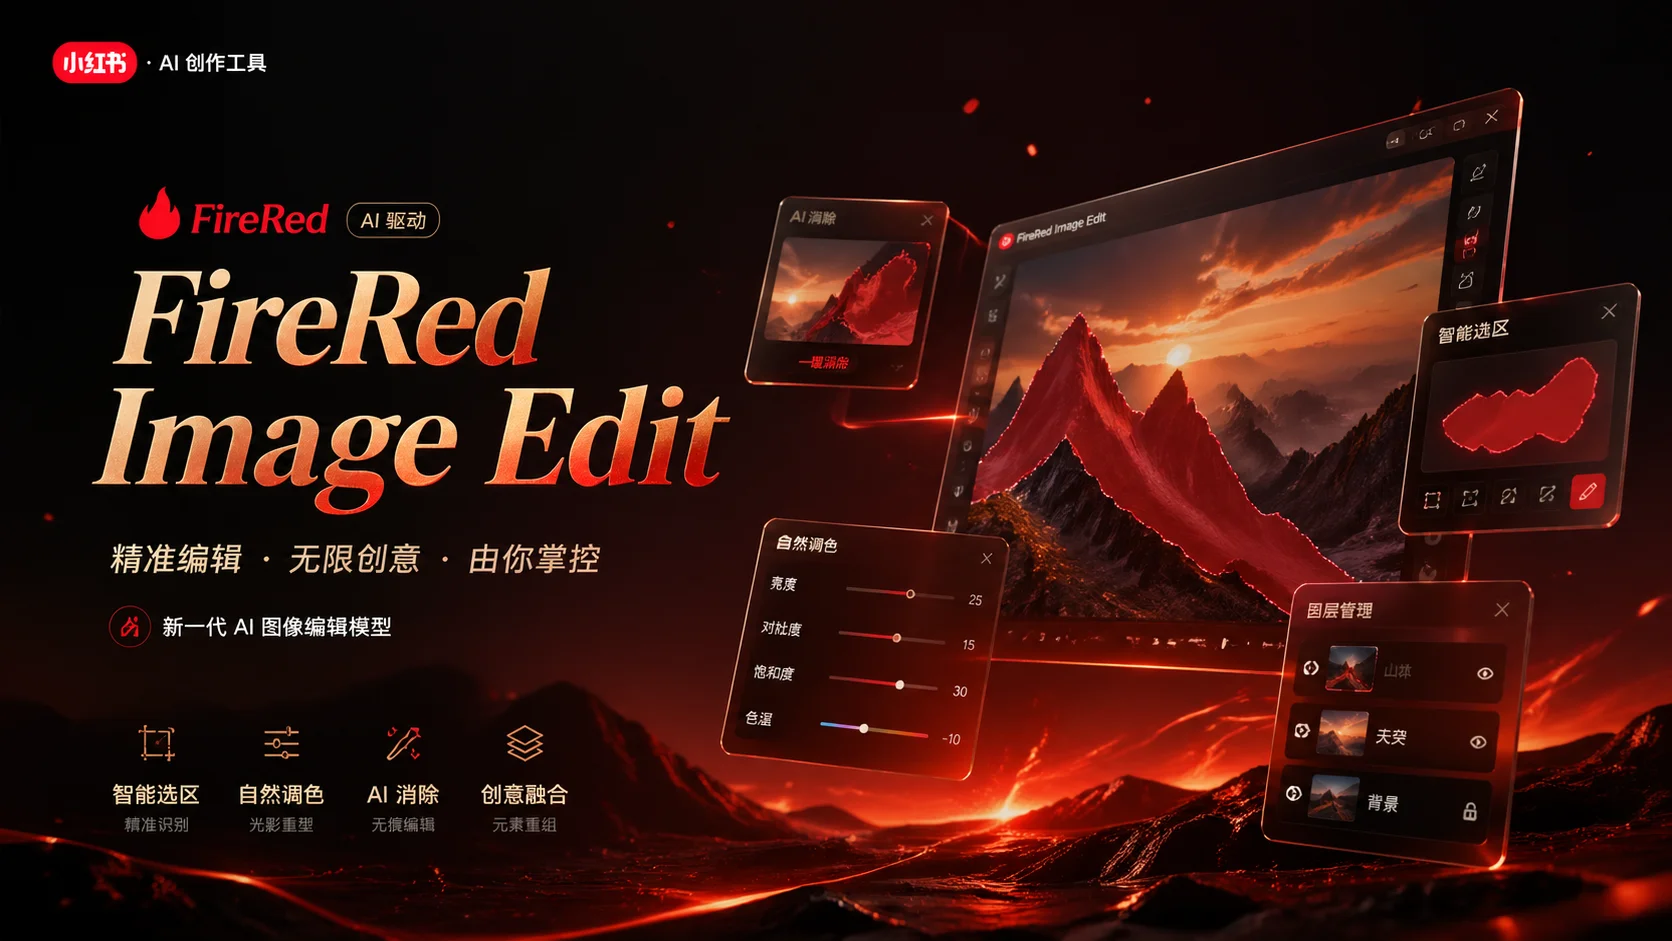
小红书 FireRed 团队开源的指令驱动AI图像编辑模型 — 覆盖添加、移除、替换、背景、风格化、文字、修复、人像妆容、多图融合、虚拟试穿10大编辑能力。基于 Diffusion Transformer 架构,原生支持中英双语指令。...
支持最多16张参考图与3000字符长提示词,适合高一致性图像生成、品牌物料和复杂场景创作
支持 4K 超高清输出和完美提示词理解的专业级 AI 图像生成器

具备原生音频生成和真实物理渲染能力的专业级 AI 视频生成器
OpenAI最先进的通用视频生成模型——从文本提示词和图像创建高质量视频,具备逼真的物理效果、富有表现力的角色和电影级视觉叙事。在 GPT Image 2.5 体验。
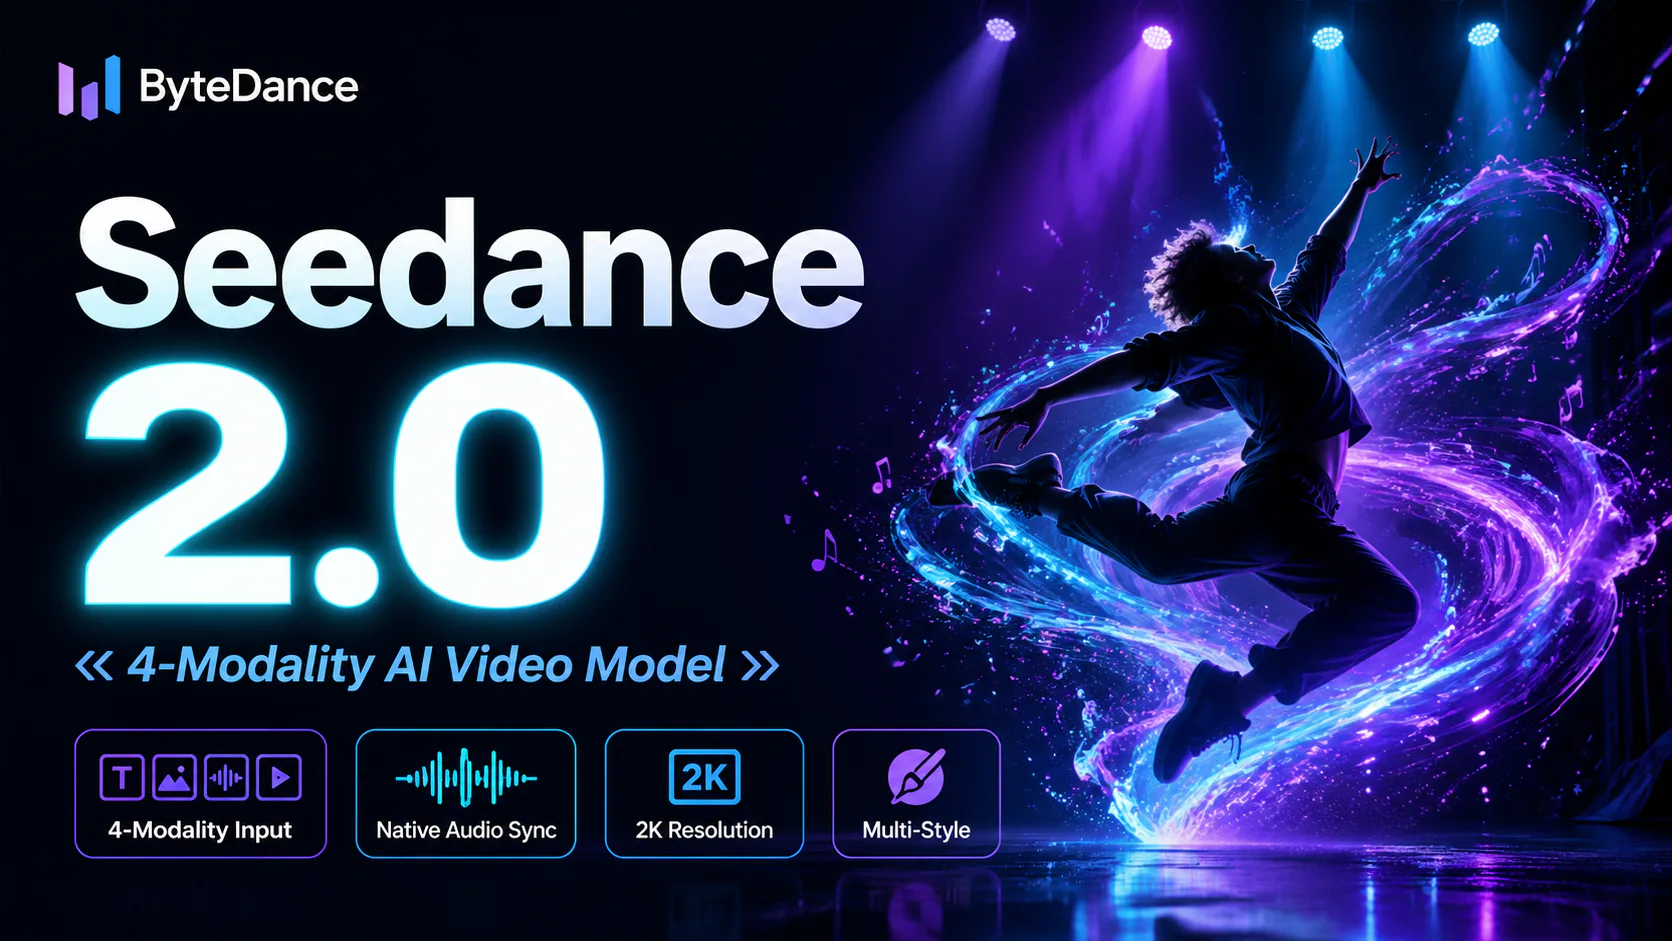
字节跳动新一代AI视频模型,搭载革命性的 @-reference 系统。将文字、图片、视频片段和音频融合在单一提示词中。原生音视频同步、V2V编辑、最高2K分辨率30fps输出——全部在统一的生成流程中完成。
 10,000+