AI 草图转图片生成器
上传或画几笔草图,说明主体和画面方向,生成更完整的图片概念。工具会参考草图构图,但不是逐线描摹或矢量转换,适合快速验证插画、分镜、角色设计、课堂练习和早期提案。先确认方向,合适后进入精修。
上传或画几笔草图,说明主体和画面方向,生成更完整的图片概念。工具会参考草图构图,但不是逐线描摹或矢量转换,适合快速验证插画、分镜、角色设计、课堂练习和早期提案。先确认方向,合适后进入精修。
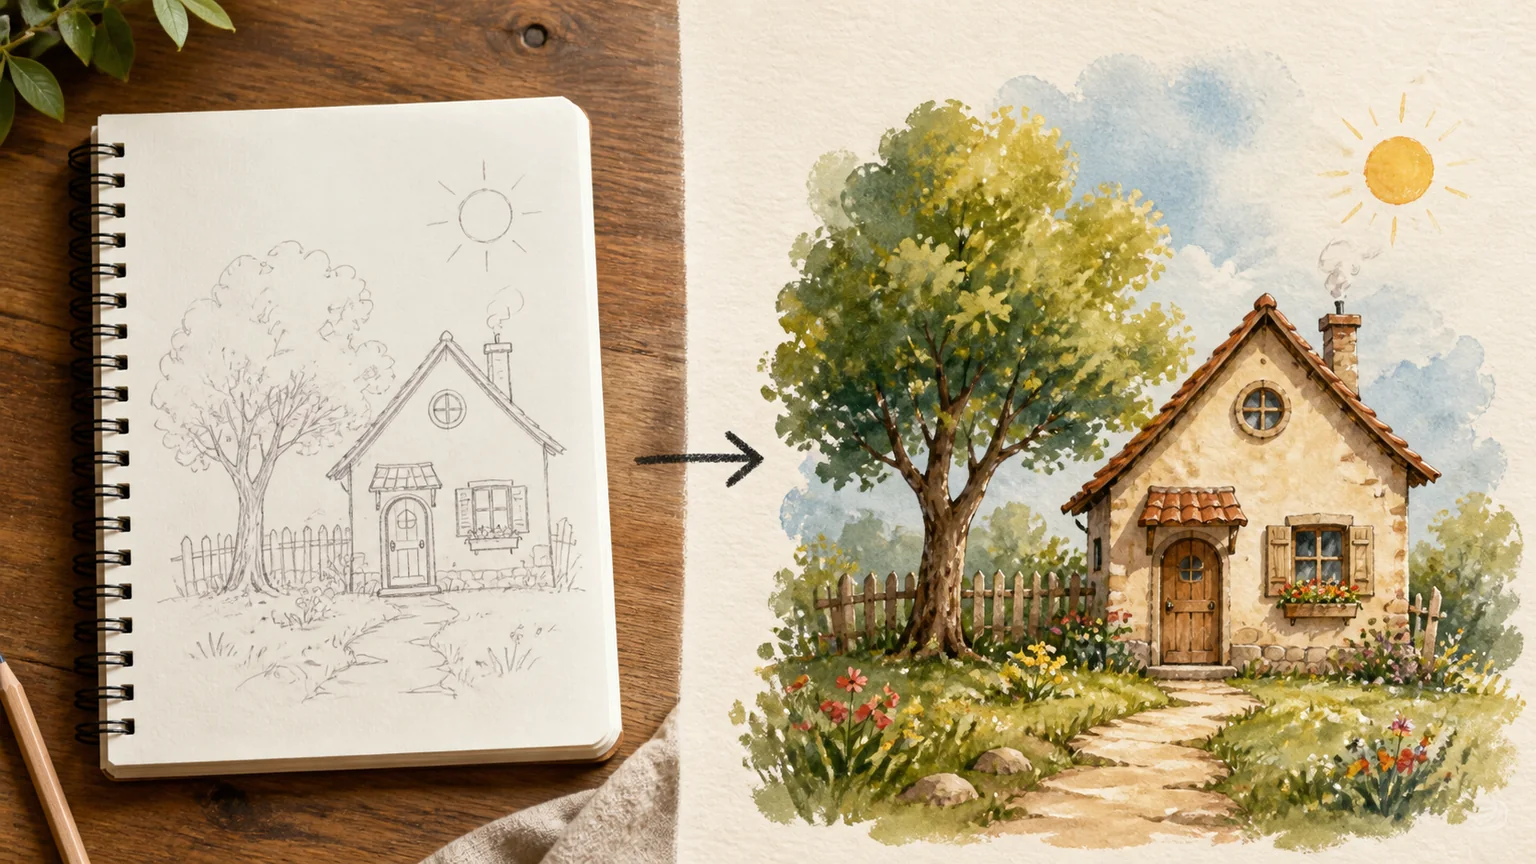
先用几笔线条画出主体和位置,再补充一句话说明动作或场景。工具会把草图当作构图依据,把文字说明当作画面背景,然后补足色彩、材质、光线和环境。这样不用先完成精细线稿,也能看到比较完整的图片方向。
人物、道具和背景只要在同一画面中的关系明确,就可以先用 AI 草图转图片测试构图。它适合插画提案、漫画分镜、绘本构思和产品创意。先确认画面是否成立,再投入时间完善线条和细节,修改成本会更低。
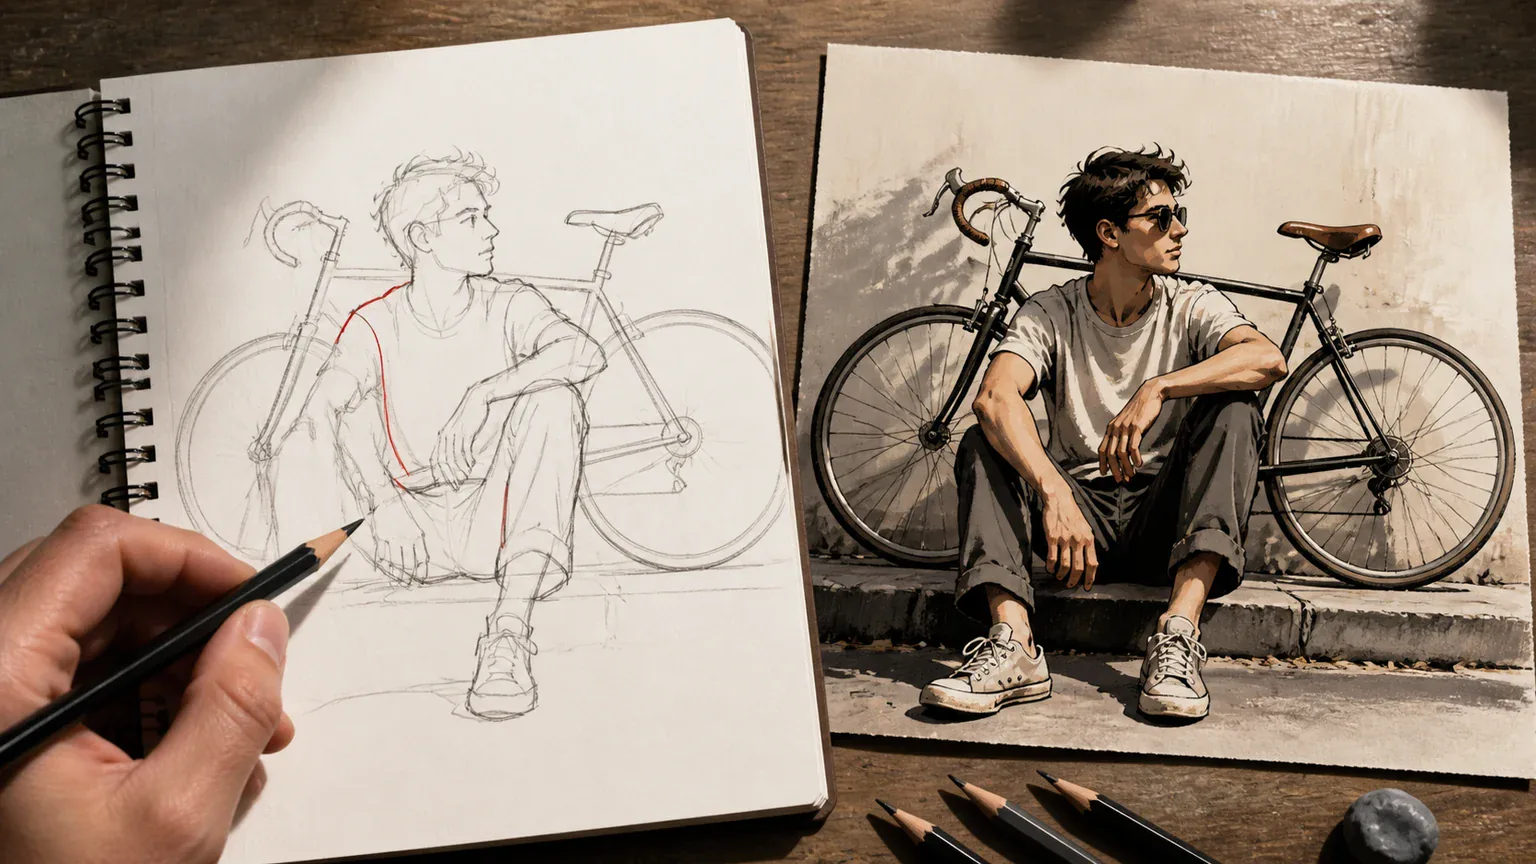
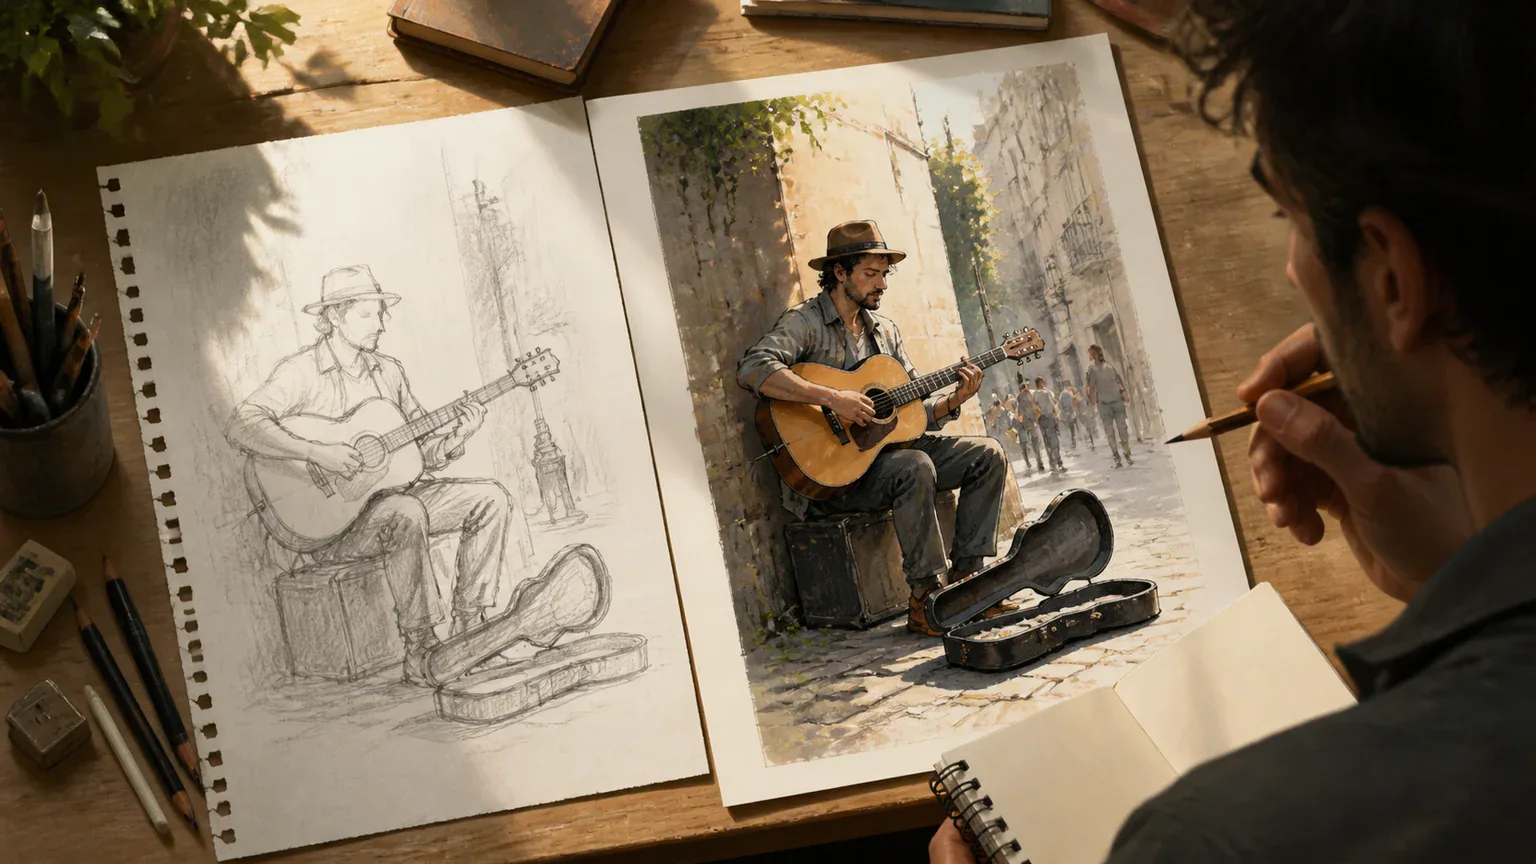
分享图片前,把结果和原始草图放在一起比较,重点看主体、姿势、物体数量、相对比例和草图里的文字。线条过少时,模型可能重新理解动作或空间关系;如果意思发生变化,应先补清楚草图,而不是不断加长提示词。
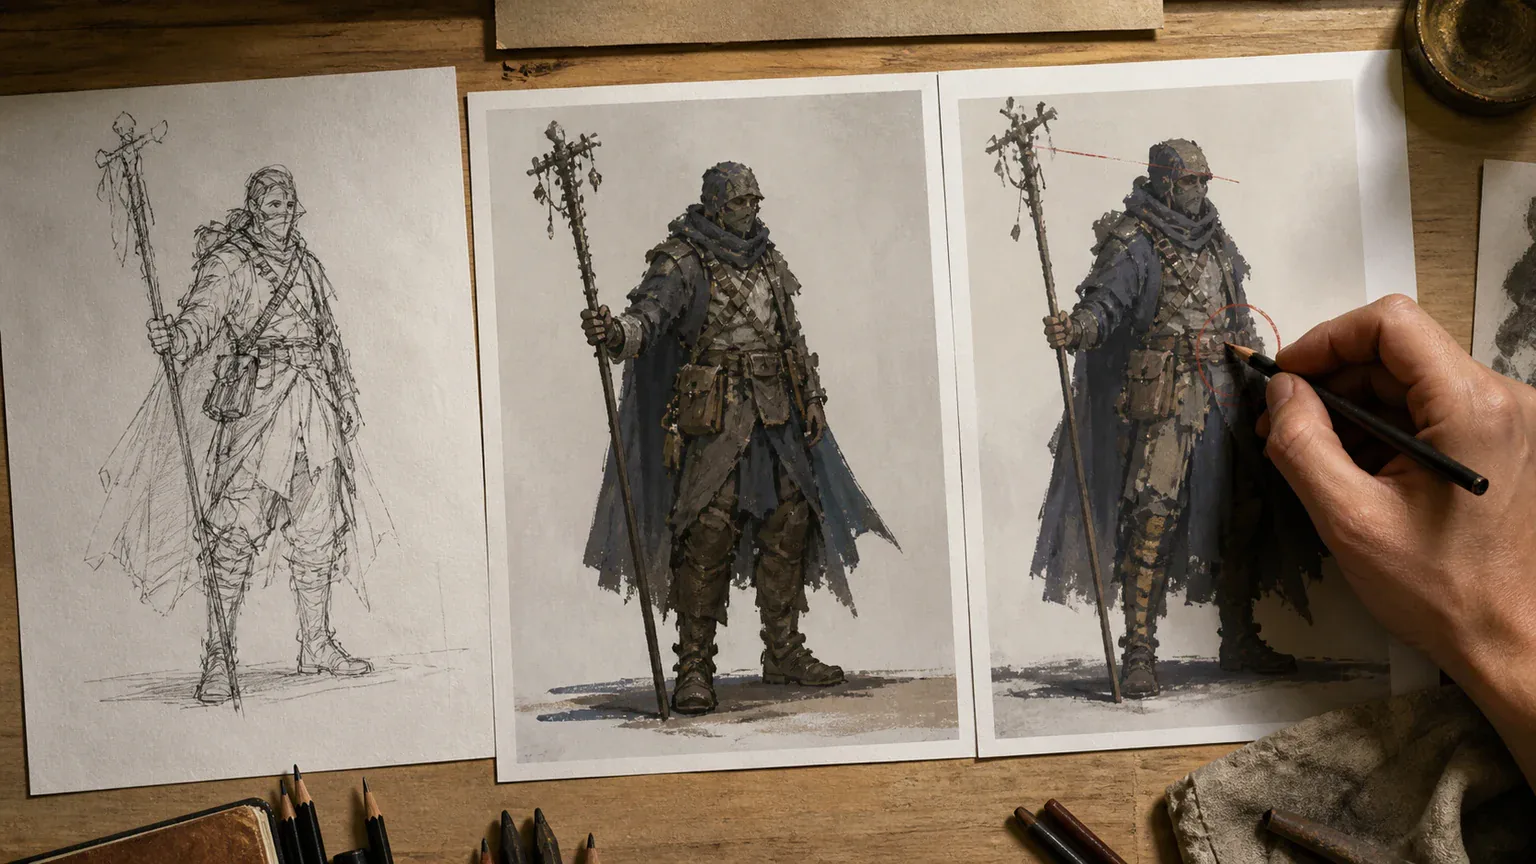
AI 草图转图片适合快速表达方向,生成图可以用于分镜讨论、设计简报和早期提案。需要准确字体、尺寸、Logo 或关键轮廓时,应在设计软件中重新绘制。把它当作能帮助团队理解想法的视觉草稿,效果会更符合工具的实际能力。
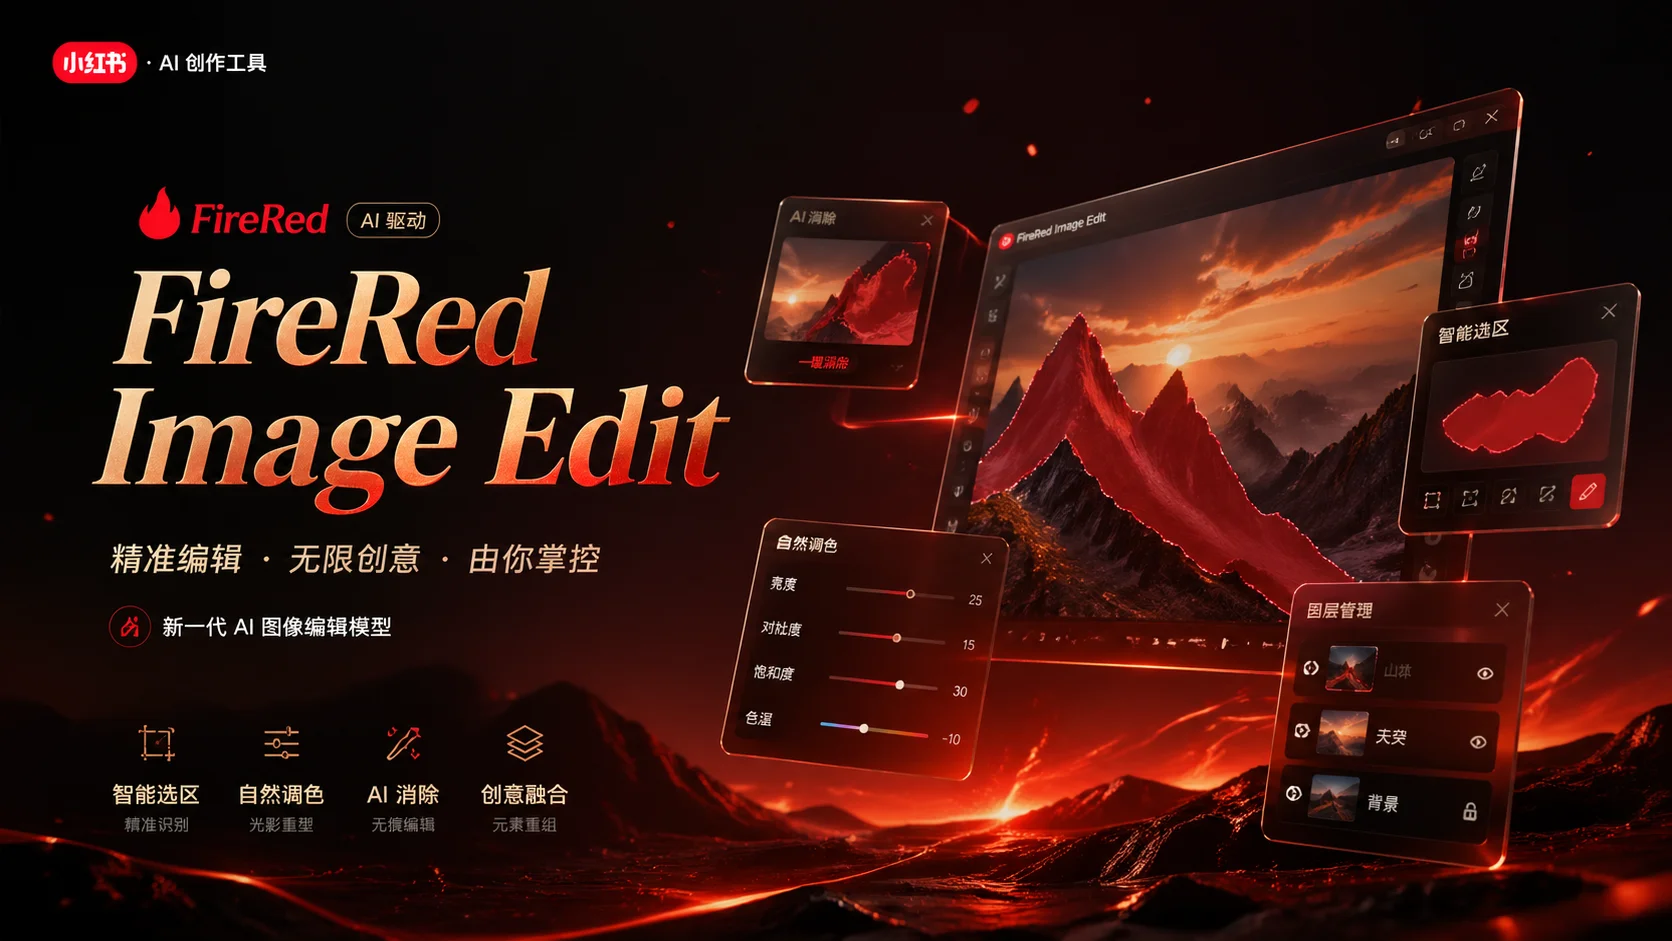
小红书 FireRed 团队开源的指令驱动AI图像编辑模型 — 覆盖添加、移除、替换、背景、风格化、文字、修复、人像妆容、多图融合、虚拟试穿10大编辑能力。基于 Diffusion Transformer 架构,原生支持中英双语指令。...
支持最多16张参考图与3000字符长提示词,适合高一致性图像生成、品牌物料和复杂场景创作
支持 4K 超高清输出和完美提示词理解的专业级 AI 图像生成器

具备原生音频生成和真实物理渲染能力的专业级 AI 视频生成器
OpenAI最先进的通用视频生成模型——从文本提示词和图像创建高质量视频,具备逼真的物理效果、富有表现力的角色和电影级视觉叙事。在 GPT Image 2.5 体验。
字节跳动新一代AI视频模型,搭载革命性的 @-reference 系统。将文字、图片、视频片段和音频融合在单一提示词中。原生音视频同步、V2V编辑、最高2K分辨率30fps输出——全部在统一的生成流程中完成。
 10,000+