Wan 3.0 Video Prime으로 장면을 구체화하세요
설명할 수 있는 장면, 움직임을 넣고 싶은 이미지 또는 방향을 보여 주는 참조 자료로 시작하세요. GPT Image 2.5 영상 생성기에서 Wan 3.0 Video Prime을 선택하고, 보유한 자료에 맞는 입력 모드를 정한 뒤 영상 구성을 준비합니다.
Prime을 위한 기획 준비
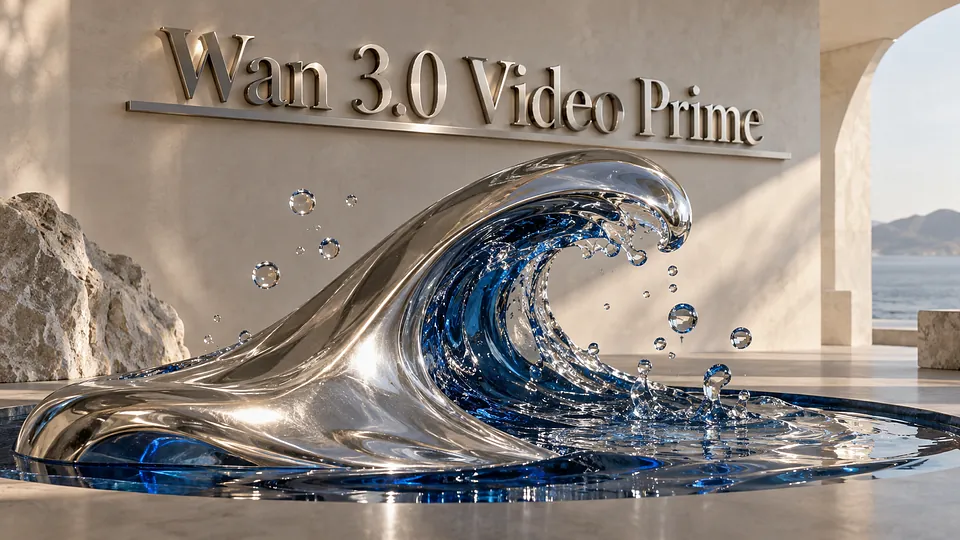
GPT Image 2.5에서 Wan 3.0 Video Prime은 일반 Wan 3.0 Video와 구분되는 모델 선택 항목입니다. 프롬프트에는 피사체, 핵심 동작, 카메라 움직임을 순서대로 적으세요. 텍스트, 이미지, 참조 자료를 활용하는 방식은 선택한 모드와 생성기에 표시되는 입력 설정에 따라 달라집니다.
영상을 위한 네 가지 선택
아이디어에 맞는 입력
주요 기능
장면의 변화를 설명하기
텍스트로 영상을 만들 때는 피사체와 배경부터 정하고 동작, 카메라 방향, 마무리를 덧붙입니다. 제품을 드러내는 장면이나 분위기 중심의 짧은 영상도 명확한 흐름이 있으면 완성 후 의도와 비교하기 쉽습니다.
시작과 끝 프레임의 역할
프레임 모드에서는 첫 프레임이 필수입니다. 마지막 프레임은 선택 사항이며 첫 이미지와 함께 제공해야 합니다. 원하는 움직임을 설명하고 마지막 이미지를 넣는 경우 두 장면 사이의 전환도 적으세요. 업로드 전에 구도와 피사체 위치를 살펴 움직임이 제공한 화면과 어울리는지 확인하세요.
목적이 분명한 참조 자료
기존 자료로 장면의 방향을 잡으려면 참조 모드를 선택합니다. 어떤 자료가 외형, 움직임 또는 소리를 안내하는지 적고 서로 충돌하는 지시는 피하세요. 파일 수를 늘리는 것만으로 원하는 결과가 명확해지지는 않습니다.
전송 전에 출력 설정 확인
GPT Image 2.5는 480p, 720p, 1080p와 5초 간격의 5~30초 길이 옵션을 제공합니다. 용도에 맞는 화면 비율을 고르고 소리 설정도 확인하세요. 완성 후에는 첫 장면, 움직임, 마지막 장면을 검토한 뒤 다운로드합니다.
시작 전 자주 묻는 질문
Wan 3.0 Video Prime으로 장면을 구체화하세요 FAQ
더 많은 AI 비디오 모델 탐색


 +1k